DPテーブルの初期化
Googleの検索窓に入力したキーワードのスペルミスを補正する「もしかして?」機能や、顧客データベース内の表記揺れを整える名寄せ作業。これら日常のあらゆるデジタル技術の根底で稼働しているのが、レーベンシュタイン距離(Levenshtein Distance)と呼ばれる文字列解析アルゴリズムです。
1965年に旧ソ連の科学者ウラジーミル・レーベンシュタインが考案したこの編集距離の理論は、現在の大規模自然言語処理(NLP)や遺伝子配列解析、さらにはLLM(大規模言語モデル)のハルシネーション評価に至るまで、文字列の類似度判定において揺るぎない基礎技術として君臨しています。アルゴリズムの基礎原理から動的計画法(DP)による高速計算のカラクリ、Pythonでの実装手法、そして他の類似度指標との決定的な違いまでを徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:レーベンシュタイン距離は「挿入・削除・置換」の最小操作回数で2つの文字列間の違いを定量化する編集距離の代表格。
- 要点2:動的計画法(DP)のテーブル遷移を活用することで、計算量O(N×M)で確実に最短編集経路を特定可能。
- 要点3:Pythonの標準実装や高速C言語バインディング(RapidFuzz等)の使い分けが、実務の大規模データ処理における成否を分ける。
【基本原理】レーベンシュタイン距離とは?編集操作から読み解く計算の仕組み
レーベンシュタイン距離は、ある文字列を別の文字列へと変換するために必要な「文字の挿入」「文字の削除」「文字の置換」の最小操作回数を数値化したものです。この操作回数が少なければ少ないほど2つの文字列は似ており、数値が0であれば完全一致を意味します。
具体的な変換プロセスを「kitten」から「sitting」への変形例で確認してみましょう。
- ステップ1(置換):先頭の「k」を「s」に置換する(sitten)[コスト1]
- ステップ2(置換):4文字目の「e」を「i」に置換する(sittin)[コスト1]
- ステップ3(挿入):末尾に「g」を挿入する(sitting)[コスト1]
上記の手順により、最小3回の操作で変換が完了するため、両者間のレーベンシュタイン距離は3となります。
さらに実務では、単なる操作回数だけでなく「類似度(0.0〜1.0)」として正規化して評価するケースが一般的です。2つの文字列の長さをそれぞれ $L_1$、$L_2$、レーベンシュタイン距離を $D$ と置いた場合、文字列類似度は以下の計算式で求められます。
$$\text{Similarity} = 1 - \frac{D}{\max(L_1, L_2)}$$
「kitten」(長さ6)と「sitting」(長さ7)の場合、$1 - (3 / 7) \fallingdotseq 0.571$ となり、類似度約57.1%と算出されます。
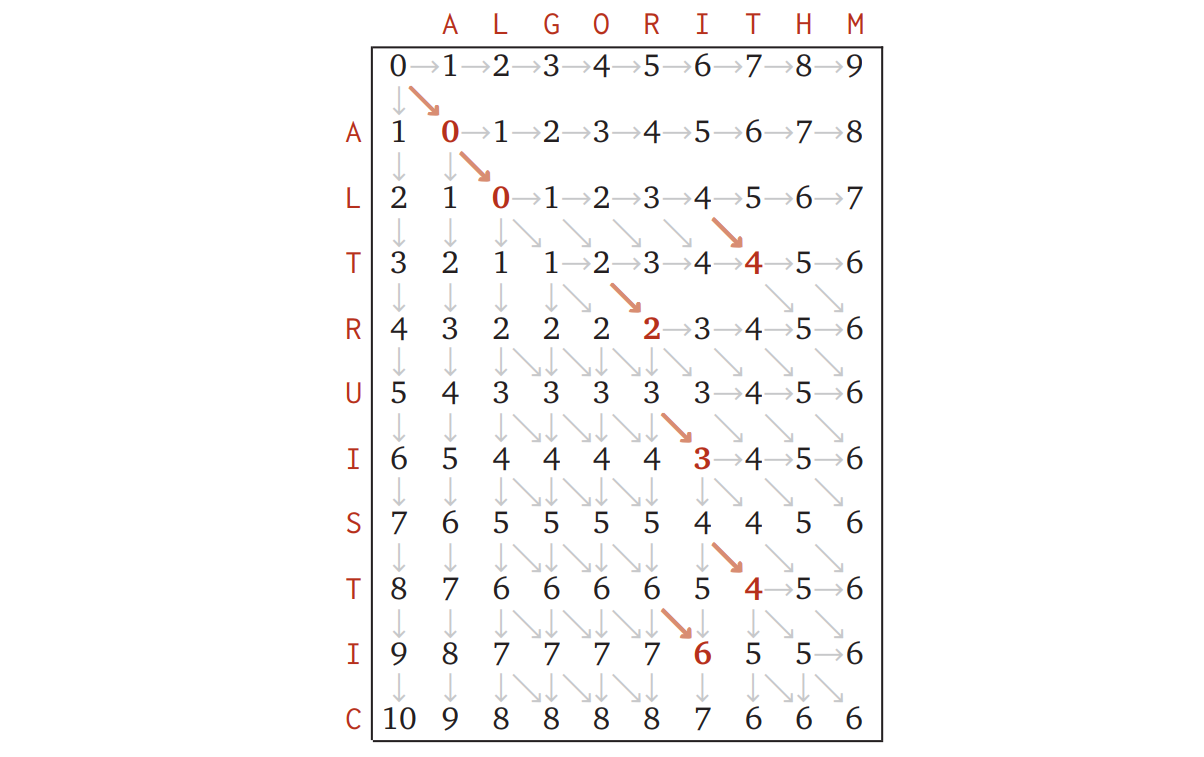
動的計画法(DP)で解くアルゴリズムと編集距離行列の可視化
文字列が長くなると、総当たり(ブルートフォース)で最小編集回数を探すアプローチは計算量が指数関数的に爆発し、実用破綻を起こします。そこで採用されるのが動的計画法(Dynamic Programming: DP)です。
DPを用いる場合、2次元の編集距離行列(DPテーブル)を作成し、部分問題の最適解を順番に埋めていきます。サイズ $(N+1) \times (M+1)$ のグリッドを用意し、各セル $(i, j)$ における値 $dp[i][j]$ は以下の漸化式に従って左上から右下へと更新されます。
$$dp[i][j] = \begin{cases} \max(i, j) & \text{if } \min(i, j) = 0 \\ \min \begin{cases} dp[i-1][j] + 1 & \text{(削除)} \\ dp[i][j-1] + 1 & \text{(挿入)} \\ dp[i-1][j-1] + \text{cost} & \text{(置換または一致)} \end{cases} & \text{otherwise} \end{cases}$$
※一致している場合は $\text{cost} = 0$、異なる文字への置換なら $\text{cost} = 1$。
例えば「CAT」と「HAT」を比較する場合、先頭文字「C」と「H」の置換コスト1が斜め遷移で伝播し、残る「A」「T」が一致するため、右下最終セルの値は1となり、極めてシンプルな行列計算だけで最適解を導き出すことができます。
【言語別実装】PythonとC言語で組むレーベンシュタイン距離のコード
実際の開発現場で直ちに活用できるよう、Pythonによる標準DP実装と、高速化ライブラリの利用法、さらに組み込み系や高速バッチ処理で重宝されるC言語のロジックを紹介します。
1. Pythonによる動的計画法のピュア実装
外部ライブラリに依存せず、標準機能だけでアルゴリズムの挙動を完全に再現するスクリプトです。
def levenshtein_distance(s1: str, s2: str) -> int: len1, len2 = len(s1), len(s2) dp = [[0] * (len2 + 1) for _ in range(len1 + 1)] for i in range(len1 + 1): dp[i][0] = i for j in range(len2 + 1): dp[0][j] = j for i in range(1, len1 + 1): for j in range(1, len2 + 1): cost = 0 if s1[i - 1] == s2[j - 1] else 1 dp[i][j] = min( dp[i - 1][j] + 1, # 削除 dp[i][j - 1] + 1, # 挿入 dp[i - 1][j - 1] + cost # 置換 ) return dp[len1][len2] # 実行例 word1 ="システム開発" word2 ="システム運用" dist = levenshtein_distance(word1, word2) print(f"編集距離: {dist}") # 出力: 2 2. 実務向け高速ライブラリ(RapidFuzz)の活用
数万件規模のレコード突合を行う現場において、Pure Pythonの2重ループはボトルネックとなります。2026年現在のプロダクション環境では、C++実装で極限まで最適化されたRapidFuzzが標準的な選択肢です。
from rapidfuzz.distance import Levenshtein # 距離の算出 dist = Levenshtein.distance("東京都千代田区", "東京都中央区") # 類似度の算出(0.0〜1.0) similarity = Levenshtein.normalized_similarity("東京都千代田区", "東京都中央区") print(f"距離: {dist}, 類似度: {similarity:.4f}") 3. C言語によるメモリ効率化実装
C言語では、2次元配列をまるごと確保せず「直前の1行」のみを保持する省メモリ化テクニック(Space Optimization)が定石です。これにより空間計算量を $O(N)$ まで削減できます。
#include <stdio.h> #include <string.h> #include <stdlib.h> int min3(int a, int b, int c) { int m = a; if (b < m) m = b; if (c < m) m = c; return m; } int levenshtein_c(const char *s1, const char *s2) { int len1 = strlen(s1); int len2 = strlen(s2); int *v0 = (int *)malloc((len2 + 1) * sizeof(int)); int *v1 = (int *)malloc((len2 + 1) * sizeof(int)); for (int j = 0; j <= len2; j++) v0[j] = j; for (int i = 0; i < len1; i++) { v1[0] = i + 1; for (int j = 0; j < len2; j++) { int cost = (s1[i] == s2[j]) ? 0 : 1; v1[j + 1] = min3(v1[j] + 1, v0[j + 1] + 1, v0[j] + cost); } for (int j = 0; j <= len2; j++) v0[j] = v1[j]; } int result = v0[len2]; free(v0); free(v1); return result; } 
【徹底比較】編集距離アルゴリズムの性能と特徴一覧
文字列の類似度計算には、レーベンシュタイン距離のほかにも用途に応じた複数のアルゴリズムが存在します。プロジェクトの目的に対して最適な選定を行うための比較表を整理しました。
| アルゴリズム名称 | 許容される基本操作 | 計算量と制約 | 最適なユースケース |
|---|---|---|---|
| レーベンシュタイン距離 | 挿入・削除・置換 | $O(N \times M)$ / 長さの異なる文字列に対応 | タイポ修正、スペルチェッカー、一般的な表記揺れ補正 |
| ハミング距離 | 置換のみ | $O(N)$ / 同一文字長が必須 | 通信エラー検出、バイナリ列比較、固定長コード突合 |
| ジャロ・ウィンクラー距離 | 一致文字数・転置(入れ替え) | $O(N)$ / プレフィックス一致を重み付け | 人名・企業名突合、住所データのプレフィックス優先名寄せ |
| ダメラウ・レーベンシュタイン | 挿入・削除・置換・隣接転置 | $O(N \times M)$ / 隣り合う文字の打ち間違いを1回と計算 | キーボード入力ミスの高精度な自動修正(例: "teh"→"the") |
業務で「人名」や「住所」を突合する際は、先頭の一致度に高いスコアを与えるジャロ・ウィンクラー距離(Jaro-Winkler Distance)のほうが実務上のヒット率が高いケースが多々あります。一方で、汎用的なスペル補正や編集ログの追跡にはレーベンシュタイン距離が最も確実な指標となります。
【実態検証】利用者の生の声と現場目線で見えたリアル
データ分析現場やWebサービス開発において、レーベンシュタイン距離の導入時にはどのような課題が持ち上がるのでしょうか。第一線で活躍するエンジニアコミュニティ(GitHub、Qiita、Zenn、Stack Overflow)での実務議論を検証すると、共通する「現場のリアル」が浮き彫りになります。
特に多くの開発者が直面するのが、「Excel業務での限界」と「日本語特有のマルチバイト処理」です。
「社内マスターの顧客名寄せをExcelで完結させたい」という要望は現場で頻発しますが、Excelにはレーベンシュタイン距離を計算する標準ワークシート関数が存在しません。VBAでユーザー定義関数(UDF)を組んで数万行に適用すると、再計算に数十分を要してフリーズするトラブルが後を絶ちません。現場の知見としては、「1,000件以上の名寄せはExcelを捨て、Python(RapidFuzz)や専用の計算ツールに切り離す」のが鉄則とされています。
また、日本語環境における「全角・半角の混在」「ひらがな・カタカナの揺れ」「漢字の異体字」をそのままレーベンシュタイン距離にかけると、人間から見れば「1文字の揺れ(例:『渡邉』と『渡辺』)」であっても、文字コードレベルでは完全に別物として距離が過大評価されてしまいます。事前の正規化処理(NFKC正規化やカタカナ統一)の徹底が、現場における成否の8割を握っています。
一般に知られていない盲点とネットの誤解
Web上の技術ブログなどで散見される「レーベンシュタイン距離に関する誤解」について、アルゴリズムの数理的限界から真相を解き明かします。
誤解1:「編集距離が小さければ、文章の意味も近い」という錯覚
これは自然言語処理を始めたばかりの開発者が最も陥りやすい罠です。レーベンシュタイン距離はあくまで「表層的な文字列の並び」しか見ていません。
- 文A:「私は犬が好きです」(文字数9)
- 文B:「私は犬が嫌いです」(文字数9)
この2文のレーベンシュタイン距離はわずか2(「好き」→「嫌い」の2文字置換)であり、極めて類似度が高いと判定されます。しかし、文章の意味は正反対です。文脈やセマンティクス(意味論)の一致度を測定したい場合は、レーベンシュタイン距離ではなく、形態素解析後のTF-IDFコサイン類似度や、OpenAIのEmbedding等を用いたベクトル類似度計算を併用しなければなりません。
誤解2:「文字列がどれだけ長くてもDPテーブルで計算すれば安心」
文字列の長さが数千〜数万文字に及ぶ長文同士の比較において、通常のレーベンシュタイン距離アルゴリズムをそのまま回すのは極めて危険です。計算量は $O(N \times M)$ であるため、1万文字同士の比較では1億回の演算ループと相応のメモリ割り当てが発生します。
長文ドキュメントの差分検出には、DPテーブル全体を展開するのではなく、最短編集グラフ上を探索するMyersの差分アルゴリズム(git diffで採用)や、ハッシュ値を活用したLocality-Sensitive Hashing(LSH)などのアルゴリズムを選択するのが計算科学上の正しいアプローチです。
【プロの結論】レーベンシュタイン距離の採用判断基準
システム設計やデータクレンジングにおいて、レーベンシュタイン距離を「採用すべきケース」と「避けるべきケース」の境界線を明確に提示します。
レーベンシュタイン距離の採用が最適な場面
- 短〜中程度の文字列突合:商品名、ユーザー入力の検索クエリ、型番、メールアドレスの入力ミス検知。
- 文字の並び順が重要となるケース:DNA塩基配列の比較、OCR(光学文字認識)による誤認識文字の修復。
- ブラックボックスを排除したい要件:AI/機械学習モデルのスコアではなく、監査可能で確定的なルールベースの距離メトリクスが必要な金融・公的システム。
レーベンシュタイン距離を避けるべき場面
- 語順の入れ替わりが許容されるケース:「山田 太郎」と「太郎 山田」の比較。レーベンシュタイン距離では大きく離れてしまうため、単語単位のJaccard係数やToken Sort Ratioを用いるべきです。
- 数百万件規模のリアルタイム全件検索:データベースの全レコードに対してオンザフライで距離計算を実行するとサーバーリソースが枯渇します。転置インデックスやトリグラム(N-gram)による事前絞り込みが必須です。
- 深い文脈理解が必要な要約・チャットボット評価:BERTScoreやLLM-as-a-Judgeなど、意味論的評価指標を選択してください。
【レーベン シュタイン 距離】に関するよくある質問(FAQ)
Q1:ハミング距離との決定的な違いは何ですか?
A1:ハミング距離は「同じ長さの文字列」において異なる文字の個数を数えるだけのアルゴリズムです(置換操作のみ)。文字の挿入や削除によって文字数が変わるケース(例:「abc」と「abzc」)には対応できません。一方、レーベンシュタイン距離は文字数が異なる文字列間でも挿入・削除を考慮して正確な距離を算出できます。
Q2:Pythonで数百万行の文字列ペアを高速に比較するにはどうすればよいですか?
A2:標準のループ処理ではなく、C++最適化ライブラリであるrapidfuzz.process.cdistを利用し、並列処理(マルチスレッド)を有効化してください。さらに、文字長が極端に離れているペアを事前に弾く「長さフィルタ」を前段に挟むことで、無駄な距離計算を90%以上削減できます。
Q3:Excel上で手軽に計算ツールとして使う方法はありますか?
A3:標準関数では不可能なため、Excel VBAモジュールにレーベンシュタイン距離を計算する関数コードを貼り付けてユーザー定義関数として呼び出すか、Python in Excel環境が利用可能な場合は`rapidfuzz`や`Levenshtein`ライブラリをシート内で直接呼び出す構成が推奨されます。
Q4:日本語(マルチバイト文字)を判定する際にスコアが狂う原因は?
A4:古いC言語ライブラリ等で文字列を「バイト長(UTF-8で日本語1文字=3バイト)」としてカウントしてしまうと、1文字の置換が3回の編集操作として誤認されます。Python 3のように文字列をUnicodeコードポイント単位(文字数)として正しく認識する環境を使用し、事前にunicodedata.normalize('NFKC', text)で全角半角を揃えてください。
まとめ:アルゴリズムの特性を理解し最適なデータ基盤を築く
レーベンシュタイン距離は、60年以上の歴史を持ちながらも、現代のデータ駆動社会において不可欠であり続ける強力なアルゴリズムです。その本質は「最小の編集操作で差分を定量化する」というシンプルな美しさにあります。
しかし、万能の特効薬ではありません。データ量が増大する現代のシステム開発では、動的計画法の計算コストを踏まえたライブラリの選定(Pure PythonからRapidFuzzやC++バインディングへの移行)や、意味論を捉えるベクトル検索とのハイブリッド設計が求められます。アルゴリズムの得意・不得意の境界線を正しく見極め、高精度で堅牢なテキスト解析基盤を構築してください。 (出典: レーベン シュタイン 距離(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
