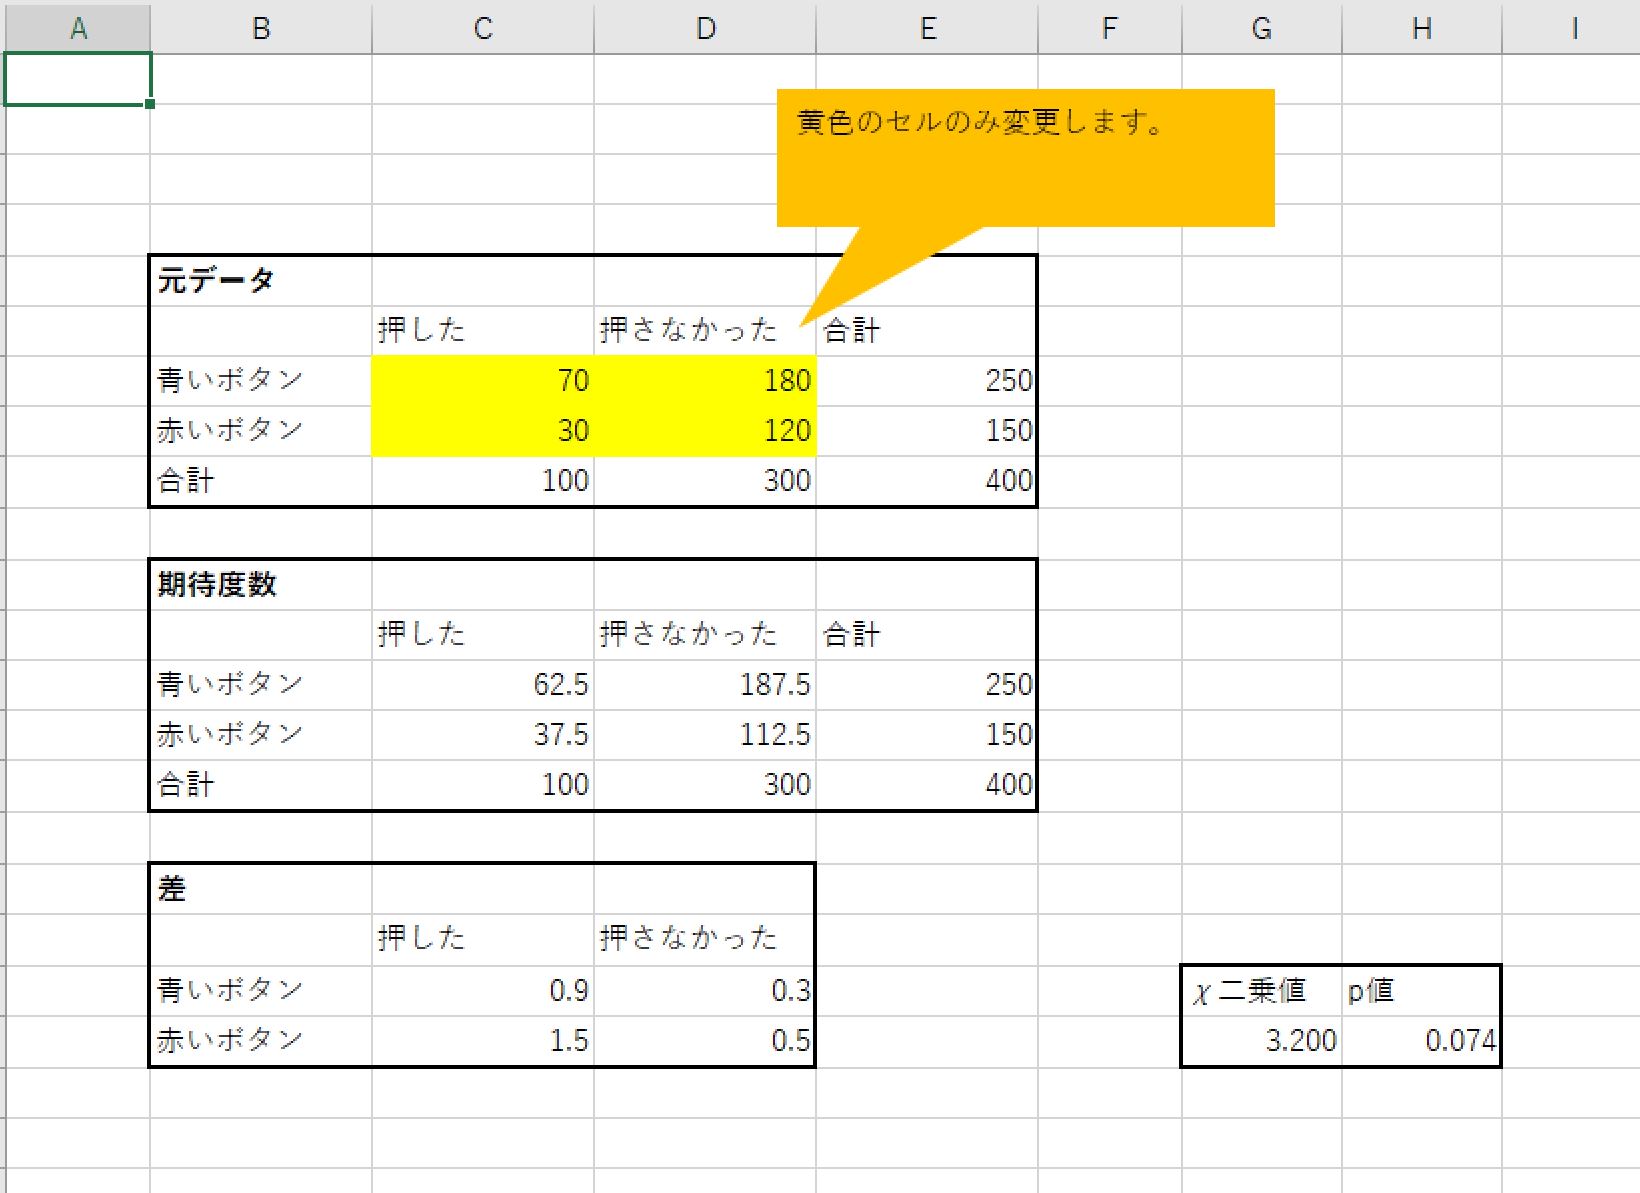
観測度数(2x2の分割表:例 [[男性購入, 男性非購入], [女性購入, 女性非購入]])
アンケート調査のクロス集計表を眺めながら、「男性と女性でキャンペーンの反応率に差が出たけれど、これは単なる偶然なのだろうか、それとも統計的に意味のある差なのだろうか」と頭を抱えた経験はないでしょうか。ビジネスの現場や学術レポートにおいて、直感や思い込みだけで意思決定を下すのは大きなリスクを伴います。
そんな「2つの要素に関連性があるのか」を客観的・数学的に白黒つける強力な武器がカイ二乗検定($\chi^2$検定)です。本記事では、数式アレルギーのある初心者でも挫折しないよう、検定の仕組みやt検定との根本的な違い、分割表の読み解き方からエクセル・Python・R言語での即実践手順まで、現場目線で徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:カイ二乗検定は「偶然のズレ(期待度数)」と「実際のデータ(観測度数)」の乖離を数値化し、2項目間の関連性や比率の正しさを検証する手法。
- 要点2:平均値を比べる「t検定」とは異なり、カイ二乗検定はアンケート回答や性別などの「カテゴリ(度数)データ」を分析対象とする。
- 要点3:エクセルなら
CHISQ.TEST関数1つで即座にp値を算出可能だが、サンプルサイズ不足や期待度数5未満のマスがある場合は「フィッシャーの正確確率検定」への切り替えが必須。
【超入門】カイ二乗検定とは?3分で本質が掴める基本の仕組み
カイ二乗検定(Chi-square test)を一言で表現するなら、「手元のデータで生じている偏りが、単なる偶然のブレなのか、それとも意味のある偏り(必然)なのかを判定するテスト」です。
たとえば、コインを100回投げて表が52回、裏が48回出たとします。理論上は50回ずつ出るはずですが、2回程度のズレなら「まあ偶然の誤差だろう」と納得できるはずです。しかし、表が80回、裏が20回出たらどうでしょうか。「このコインには仕掛けがあるのではないか」と疑うのが自然です。
カイ二乗検定は、この「直感的な怪しさ」を確率として厳密に数値化します。その中核を担うのが、以下の2つの概念です。
- 観測度数(Observed frequency):実際に調査や実験で得られた現実のデータ件数。
- 期待度数(Expected frequency):もし「何の関連性もない(完全に均等・ランダム)」と仮定したときに現れるはずの理論上のデータ件数。
検定では、すべてのマスにおいて「(観測度数 - 期待度数)の2乗 ÷ 期待度数」を計算し、その合計値を算出します。この数値をカイ二乗値(統計量)と呼びます。差を2乗するのは、プラスとマイナスの相殺を防ぎ、ズレを強調するためです。
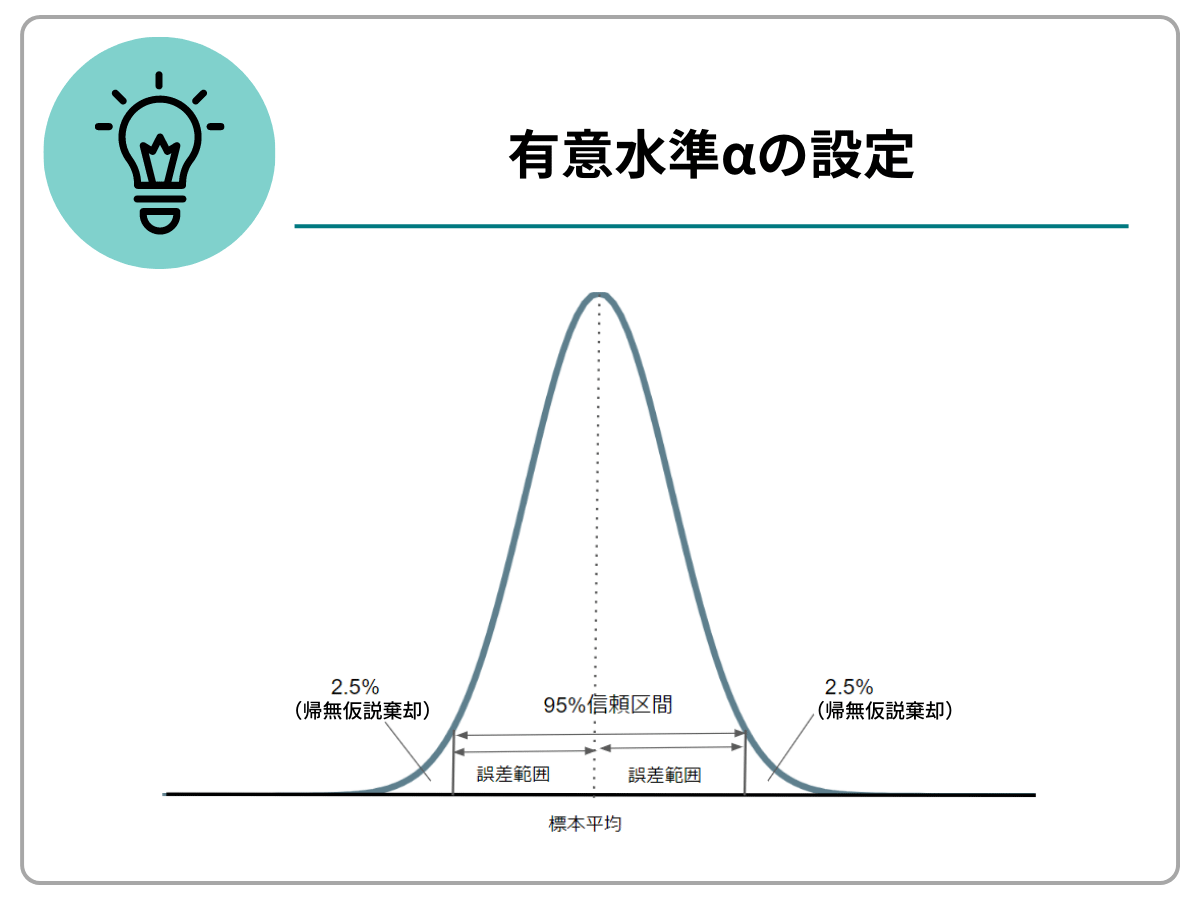
ズレがゼロに近ければカイ二乗値は小さくなり、「偶然の範囲内」と判断されます。逆にズレが巨大になればカイ二乗値が跳ね上がり、描かれるカイ二乗分布の裾野に位置することになります。その発生確率を示すのがp値であり、一般的に設定される有意水準($\alpha = 0.05$、すなわち5%)を下回ったとき、「偶然とは言えない有意な関連がある」と結論づけます。
何が違う?カイ二乗検定とt検定の使い分け|データ型で見極める決定版
データ分析初心者が最も躓きやすいのが、「自分の手元にあるデータには、カイ二乗検定を使うべきか、それともt検定を使うべきか」という疑問です。見極めの基準は極めて明確で、「扱っているデータの性質(尺度)」を見るだけで一発で判断できます。
| 検定手法 | 対象となるデータの種類 | 代表的な分析具体例 | 編集部の見解・選択の目安 |
|---|---|---|---|
| カイ二乗検定 | 質的データ(カテゴリ・度数) 人数、件数、割合など | ・性別による新商品の購入有無 ・Web広告デザインA/Bのクリック割合 | 「はい/いいえ」や選択肢ごとの人数の偏り・割合を比較したい場合に最適。 |
| t検定 | 量的データ(連続数値) テスト点数、金額、身長、時間など | ・男性と女性の平均購入金額の違い ・新薬投与前後の血圧の平均値変化 | 2グループ間の「平均値」に統計的な差があるかを比べたい場合に必須。 |
| 分散分析(ANOVA) | 量的データ(連続数値) 3グループ以上の連続変数 | ・東京・大阪・名古屋の平均売上比較 ・年代別(20代/30代/40代)の滞在時間 | t検定を3群以上に拡張した手法。平均値の差を一度に検定する。 |
要するに、「売上金額の平均に差があるか」を調べたいならt検定、「購入した人数の割合に差があるか」を調べたいならカイ二乗検定を選びます。ここを取り違えると、分析全体の前提が崩れてしまうため注意してください。
「独立性の検定」と「適合度の検定」|実務で使う2大パターンの違い
カイ二乗検定には、実務で頻繁に使われる2つの型が存在します。大半のビジネスシーンで登場するのは「独立性の検定」ですが、レポートや品質管理では「適合度の検定」も重要な役割を果たします。
1. 独立性の検定(クロス集計表の分析)
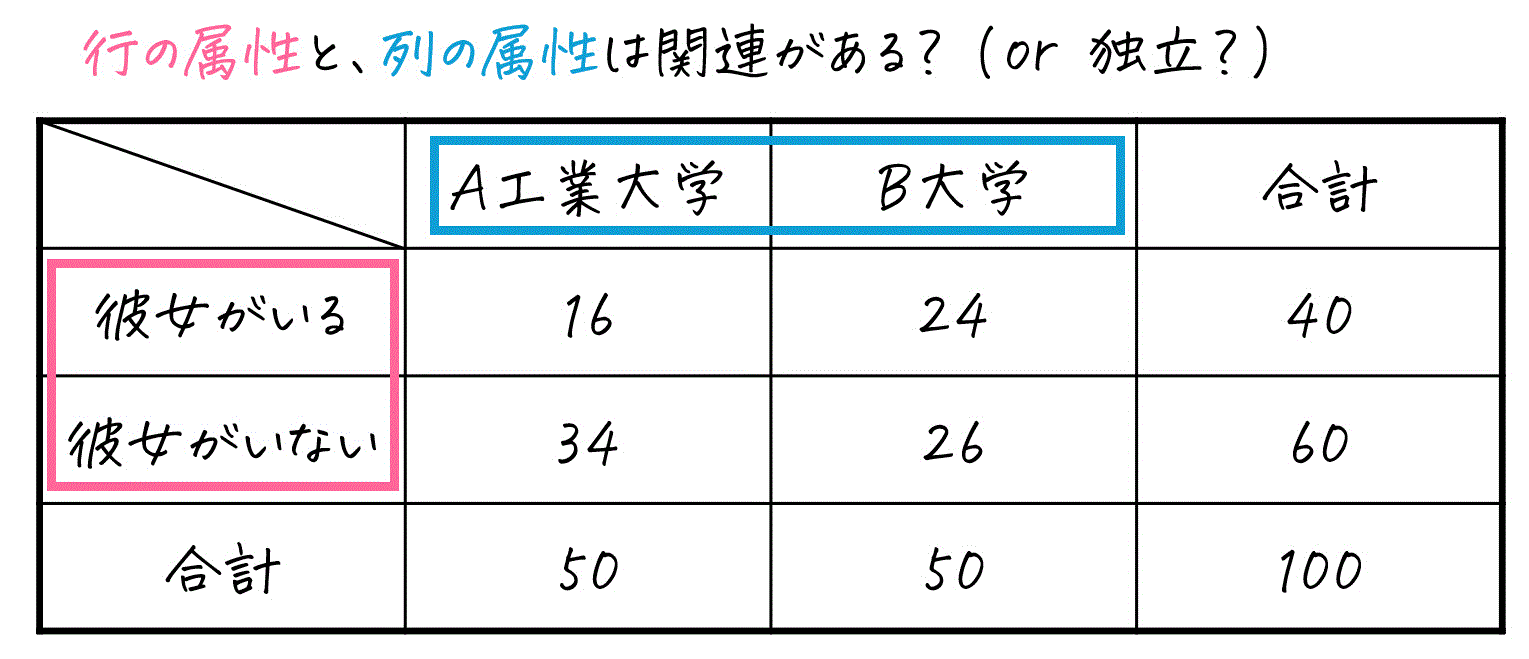
2つの変数(例:年代とスマホ決済の利用有無)の間に関係性があるか(独立しているか、それとも従属しているか)を調べる手法です。縦と横にデータを並べた分割表(クロス集計表)を用いて計算します。
ここで極めて重要になるのが自由度(df: degrees of freedom)の計算です。自由度とは、「自由に値を決められるマスの数」を指し、以下の計算式で求められます。
$$\text{自由度 } (df) = (\text{行数} - 1) \times (\text{列数} - 1)$$
たとえば、男女(2行)× 購入有無(2列)の「$2 \times 2$ 分割表」であれば、自由度は $(2 - 1) \times (2 - 1) = 1$ となります。自由度が変わると参照すべきカイ二乗分布の形が変化するため、計算ソフトを使わない手計算の場面では必須の知識となります。
2. 適合度の検定(理論比率との比較)
手元の観測データが、あらかじめ想定された理論上の比率(確率分布)に適合しているかを検証する手法です。
たとえば、メンデルの遺伝の法則(理論比率 9:3:3:1)に実際の植物の交配結果が従っているか、あるいはサイコロを600回振ったときに各目が100回ずつ均等に出ているかといった検証に用いられます。この場合の自由度は「(分類のカテゴリー数)- 1」となります。
【実践】エクセル・Python・Rでカイ二乗検定を実行する手順
現代のデータ分析現場では、手計算を行う必要は一切ありません。主要なツールを使った具体的な実行手順を解説します。
1. エクセル(Excel)での手順:わずか2ステップ
エクセルには、カイ二乗検定のp値をダイレクトに算出する強力な関数が標準搭載されています。
- 分割表(観測度数)をシート上に作成する:たとえば、セルB2:C3に「男女別の購入・非購入人数」を入力します。
- 期待度数の表を作成する:各セルの期待度数を「
(行の合計 × 列の合計) ÷ 全体の合計」の計算式で求め、セルB6:C7などに配置します。 - CHISQ.TEST関数を入力する:任意のセルに
=CHISQ.TEST(B2:C3, B6:C7)と入力します。(書式:=CHISQ.TEST(実測値範囲, 期待値範囲))
返された数値(p値)が 0.05未満 であれば、「性別と購入状況の間には統計的に有意な関連がある」と判定できます。
2. Python(SciPy)でのコード実装
Pythonを用いる場合、データサイエンス標準ライブラリscipy.statsのchi2_contingencyを使用すれば、期待度数の計算まで全自動で完了します。
import numpy as np from scipy import stats obs = np.array([[45, 55], [70, 30]]) # カイ二乗検定の実行(イェーツの補正を外す場合は correction=False) chi2, p_val, dof, expected = stats.chi2_contingency(obs, correction=False) print(f"カイ二乗統計量: {chi2:.4f}") print(f"p値: {p_val:.4e}") print(f"自由度: {dof}") print("期待度数:\n", expected) 3. R言語でのコマンド
統計解析特化言語であるR言語なら、1行のコードで検定結果が出力されます。
# データの作成(マトリックス形式) data_matrix <- matrix(c(45, 70, 55, 30), nrow = 2, dimnames = list(Gender = c("Male", "Female"), Purchase = c("Yes", "No"))) # カイ二乗検定の実行(イェーツの補正なし) chisq.test(data_matrix, correct = FALSE) 【実態検証】データ分析の現場で頻発する「落とし穴」とネットの誤解
実務現場のデータサイエンティストやリサーチャーから頻繁に報告されるのが、「検定の前提条件を無視して誤った結論を出してしまうトラブル」です。ネット上の簡易解説記事では見落とされがちな重要ポイントを検証します。
1. 「期待度数5未満」問題とフィッシャーの正確確率検定
カイ二乗検定は「大標本(サンプルサイズが十分にあること)」を前提とした近似計算を行っています。そのため、以下のコクランの基準(Cochran's criteria)を満たさない場合、計算されるp値の信頼性が激減します。
- 全マスのうち、期待度数が5未満のマスが全体の20%を超えている
- あるいは、期待度数が1未満のマスが1つでもある
このような小サンプルや偏りの大きいデータでは、カイ二乗検定を無理に適用してはいけません。代わりに、標本サイズが小さくても厳密な確率を計算できるフィッシャーの正確確率検定(Fisher's exact test)を採用するのが統計学的な鉄則です。
2. 2×2分割表における「イェーツの補正」の扱い
自由度1の「$2 \times 2$ 分割表」では、離散型のデータを連続型のカイ二乗分布に無理やり当てはめることでカイ二乗値が過大評価(有意になりやすくなる)される傾向があります。これを防ぐためにカイ二乗値を小さめに修正する処理がイェーツの連続性補正(Yates's continuity correction)です。
R言語の chisq.test() や Pythonの chi2_contingency() では、デフォルトでこの補正が有効化されています。しかし近年では、「イェーツの補正は保守的すぎる(本来有意な差まで見落とすリスクがある)」として、サンプルサイズが十分大きい場合は correct=FALSE で補正を外す運用も一般化しています。
3. サンプルサイズが大きすぎる場合の「有意差トラップ」
もうひとつの盲点がサンプルサイズ過多です。カイ二乗検定はサンプル数が1万人、10万人と増えるにつれて、ビジネス上は全く無意味な「0.1%の微細な差」であってもp値が0.0001などを叩き出し、「有意差あり」と判定されてしまいます。
現場では、p値だけでなく「効果量(クラメールの連関係数 $V$ など)」を併せて確認し、「実質的に意味のある大きさの差なのか」を評価する複眼的な視点が不可欠です。
【プロの結論】カイ二乗検定を活用すべき場面と失敗しないための判断基準
ビジネスや学術研究において、カイ二乗検定を正しく武器として活用するための判断チャートを提示します。
✅ カイ二乗検定が抜群に威力を発揮するケース
- Webマーケティング:バナーAとバナーBで、会員登録率(CVR)に統計的な差があるかを検証するA/Bテスト。
- アンケート集計:「年代(若年層/シニア層)」と「ブランド認知経路(SNS/テレビ/口コミ)」に関連があるかの分析。
- 医療・ヘルスケア:投薬グループとプラセボグループにおける症状改善の割合比較(十分なサンプル数がある場合)。
⚠️ カイ二乗検定を避けるべき・慎重になるべきケース
- 各項目のサンプル数が極端に少ない場合:迷わずフィッシャーの正確確率検定を選択する。
- 同じ被験者の前後比較(対応のあるデータ):「セミナー受講前後の賛否変化」などは独立性が成立しないため、マクネマー検定(McNemar test)を使用する。
- 3つ以上の順序関係を持つカテゴリ:「不満・普通・満足」のような順序尺度を分析する場合、カイ二乗検定では順序情報が捨てられてしまうため、マン・ホイットニーのU検定や順序ロジスティック回帰などを検討する。
【カイ 二乗 検定】に関するよくある質問(FAQ)
Q1:p値が「0.048」とギリギリ5%を下回った場合、どう解釈すべきですか?
A1:統計学的には「有意水準5%で有意差あり」と報告して問題ありません。ただし、標本抽出のわずかなブレで結果が覆る水準です。実務の意思決定においては、効果量(関連の強さ)の確認や、再現性を確かめるための追加調査を検討するのが賢明です。
Q2:エクセルのCHISQ.TESTとCHISQ.INVの違いは何ですか?
A2:CHISQ.TESTはデータ範囲を指定して直接「p値」を出力する関数です。一方、CHISQ.INVは指定した確率に対応する「カイ二乗の境界値(棄却限界値)」を逆算する関数です。日常の実務分析であれば、CHISQ.TESTだけで完結します。
Q3:分割表の縦横は何マス(何行何列)までカイ二乗検定で扱えますか?
A3:数学的な上限はなく、$3 \times 3$ や $4 \times 5$ などの多分割表でも検定可能です。ただし、マスが増えるほど「期待度数5未満のマス」が発生しやすくなるため、必要に応じてカテゴリを統合するか、サンプルサイズを十分に確保する必要があります。
まとめ:データに騙されないためのカイ二乗検定の実務活用術
カイ二乗検定は、アンケート結果やWeb上のユーザー行動といった「カテゴリカルなデータ」に潜む関連性を科学的に見極めるための、極めて実用的で汎用性の高い統計手法です。
「t検定との使い分け(量的データか質的データか)」を整理し、「期待度数と観測度数のズレを見る」という基本原理を押さえておけば、エクセルやプログラミング言語を用いて誰でも数分で信頼性の高い分析を実行できます。
単なる勘や経験則による議論から脱却し、客観的なデータに基づいた説得力ある提案・レポート作成のために、ぜひカイ二乗検定を日々の実務に役立ててください。 (出典: カイ 二乗 検定(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
