エンティティとは?IT・SEOで劇的に差がつく本質と実践ガイド
IT業界やWebマーケティングの現場で頻繁に耳にする「エンティティ」という言葉。直訳すると「実体」「存在」「実在物」を指しますが、文脈によってデータベース設計のテーブル要素を指すこともあれば、Google検索における概念識別、さらにはプログラミングにおけるデータモデルを指すこともあり、多くの初学者や担当者を悩ませています。
言葉の定義が抽象的であるがゆえに、「説明を読んでもいまいち実務での使い方が掴めない」「SEO対策においてなぜこれほど重要視されているのかが分からない」といった混乱の声は後を絶ちません。本記事では、IT用語辞典や技術標準、最新の検索アルゴリズムの動向を踏まえ、エンティティの根幹にある概念から各分野での具体的な役割、ビジネスに直結する活用術までを徹底的に解明します。
📌 【この記事の重要ポイントまとめ】
- 要点1:エンティティの本質は「属性によって説明される、他と明確に区別可能な唯一の実体・概念」である。
- 要点2:データベースでは「データ管理の対象(人・物・事)」、SEOでは「Googleがナレッジグラフで認識する概念」を意味する。
- 要点3:AI検索時代において、文字列(Keywords)から実体(Entities)への理解シフトがデジタル戦略の成否を分ける。
【基本概念】エンティティとは何か?初心者が混乱する3つの理由と正体
エンティティ(Entity)の語源は、ラテン語の「ens(存在する)」に由来し、英語の一般名詞としては「独立して存在する実体」「組織や法人などの実在概念(Legal Entityなど)」を意味します。IT用語辞典e-Wordsなどの技術リファレンスにおいても、「標識や識別名によって指し示される、独立した一意の対象物」と定義されています。
それにもかかわらず、多くの人がこの概念でつまずいてしまう背景には、主に3つの明確な要因が存在します。
第一に、「文脈によって指すレイヤーが激変する」点です。データベースエンジニアにとってのエンティティは「テーブルとして設計される顧客や商品」ですが、Webエンジニアにとっては「HTMLの特殊文字参照(©など)」を指し、SEOマーケターにとっては「Googleが概念として理解している人物や企業」を指します。土台となる世界観が異なるにもかかわらず、同じ単語が使われていることが混乱の主因です。
第二に、「実物だけでなく無形の概念も含まれる」点です。スマートフォンや人間といった物理的に触れる「物」だけでなく、「契約」「受講履歴」「ログインセッション」といった事象・関係性もすべてエンティティとして扱われます。
第三に、「属性(Attribute)や値(Value)との境界線が曖昧になりやすい」点です。初心者が理解を整理するためのエンティティ具体例として、以下のように捉えると構造が極めて明快になります。
- エンティティ(実体):「社員」という独立した管理単位
- 属性(プロパティ):社員番号、氏名、入社年月日、所属部署
- 値(インスタンスデータ):「EMP-001」「山田太郎」「2024-04-01」「開発部」
このように、「単独で固有の識別子(IDなど)を持ち、複数の属性を束ねる中心概念」こそが、情報科学におけるエンティティの普遍的な正体です。

【分野別比較】データベース・Web・SEOにおける「エンティティ」の決定的な違い
業務や学習でエンティティに向き合う際は、自身がどの領域の文脈でこの言葉を使っているかを正確に切り分ける必要があります。主要4分野における定義と役割の差異を構造化して比較します。
| 分野・領域 | エンティティの定義・具体例 | 主要な関連技術・用語 | 実務における重要度・目的 |
|---|---|---|---|
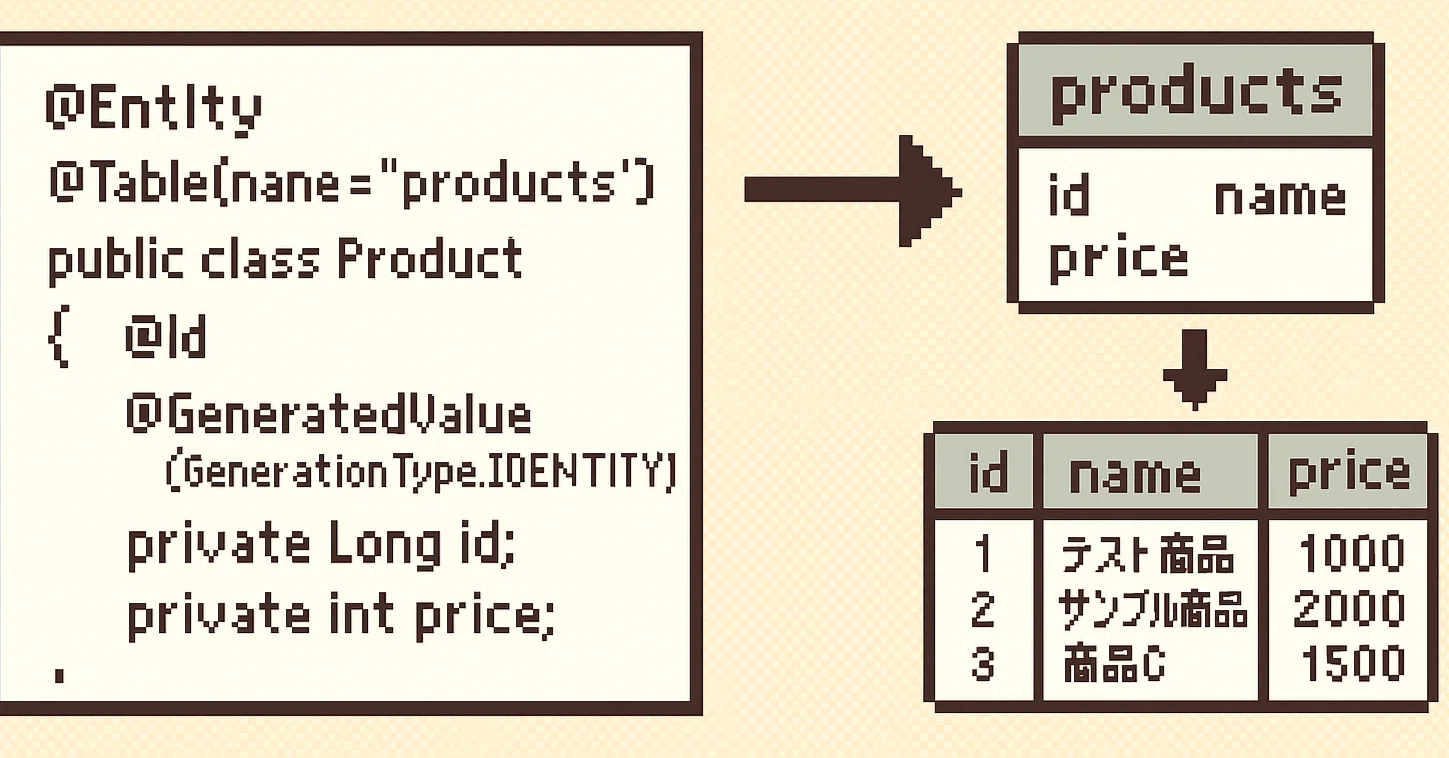
| データベース設計 | 管理対象となる「顧客」「注文」「商品」などのデータの塊 | 実体関連モデル、ER図、主キー、外部キー | データの重複を排除し、不整合を防ぐ正規化の実現 |
| 検索エンジン・SEO | 人・場所・組織・概念など、Web全体で一意に識別される存在 | ナレッジグラフGoogle、構造化データ、Schema.org | AI検索やセマンティック検索での正確な文脈理解と露出拡大 |
| ソフトウェア開発 (DDD) | 同一性を識別するIDを持ち、状態が変化し続ける業務オブジェクト | ドメイン駆動設計、値オブジェクト、集約 | 複雑なビジネスロジックの破綻を防ぎ、保守性を高める |
| Webマークアップ (HTML) | 特殊記号をWeb上で安全に表示するためのコード(文字参照) | HTMLエンティティ文字参照(<, >, &など) | 構文エラーやセキュリティ脆弱性(XSSなど)の防止 |
このように、データベースでは「データの器」、検索エンジンでは「現実世界の概念」、DDDでは「振る舞いを持つ業務対象」、HTMLでは「文字エスケープ」と、目的によって役割が大きく分かれています。
【実態検証】なぜ今Google検索でエンティティSEO対策が最重要視されるのか
近年の検索エンジンマーケティングにおいて、最も劇的な地殻変動を起こしているのがエンティティSEO対策です。Googleは2012年のナレッジグラフ導入以降、「Things, not strings(文字列ではなく実体へ)」という基本方針を掲げて検索エンジンの進化を進めてきました。
かつての検索エンジンは、ユーザーが入力したキーワードの「文字の一致」を機械的に判定していました。しかし、現代のセマンティックWeb技術とAIモデルを統合したGoogleは、単語同士の文脈的なつながり(関係性)を「実体=エンティティ」としてネットワーク状に把握しています。
例えば「アップル」と検索された際、それが「果物のリンゴ」なのか「テクノロジー企業のApple」なのかを、検索履歴や共起する他の概念(iPhone、ティム・クック、NASDAQなど)から瞬時に識別します。これが検索エンジン概念理解の基盤です。
この環境下でWebサイトが正しく評価されるためには、以下の3つの施策が決定的な鍵を握ります。
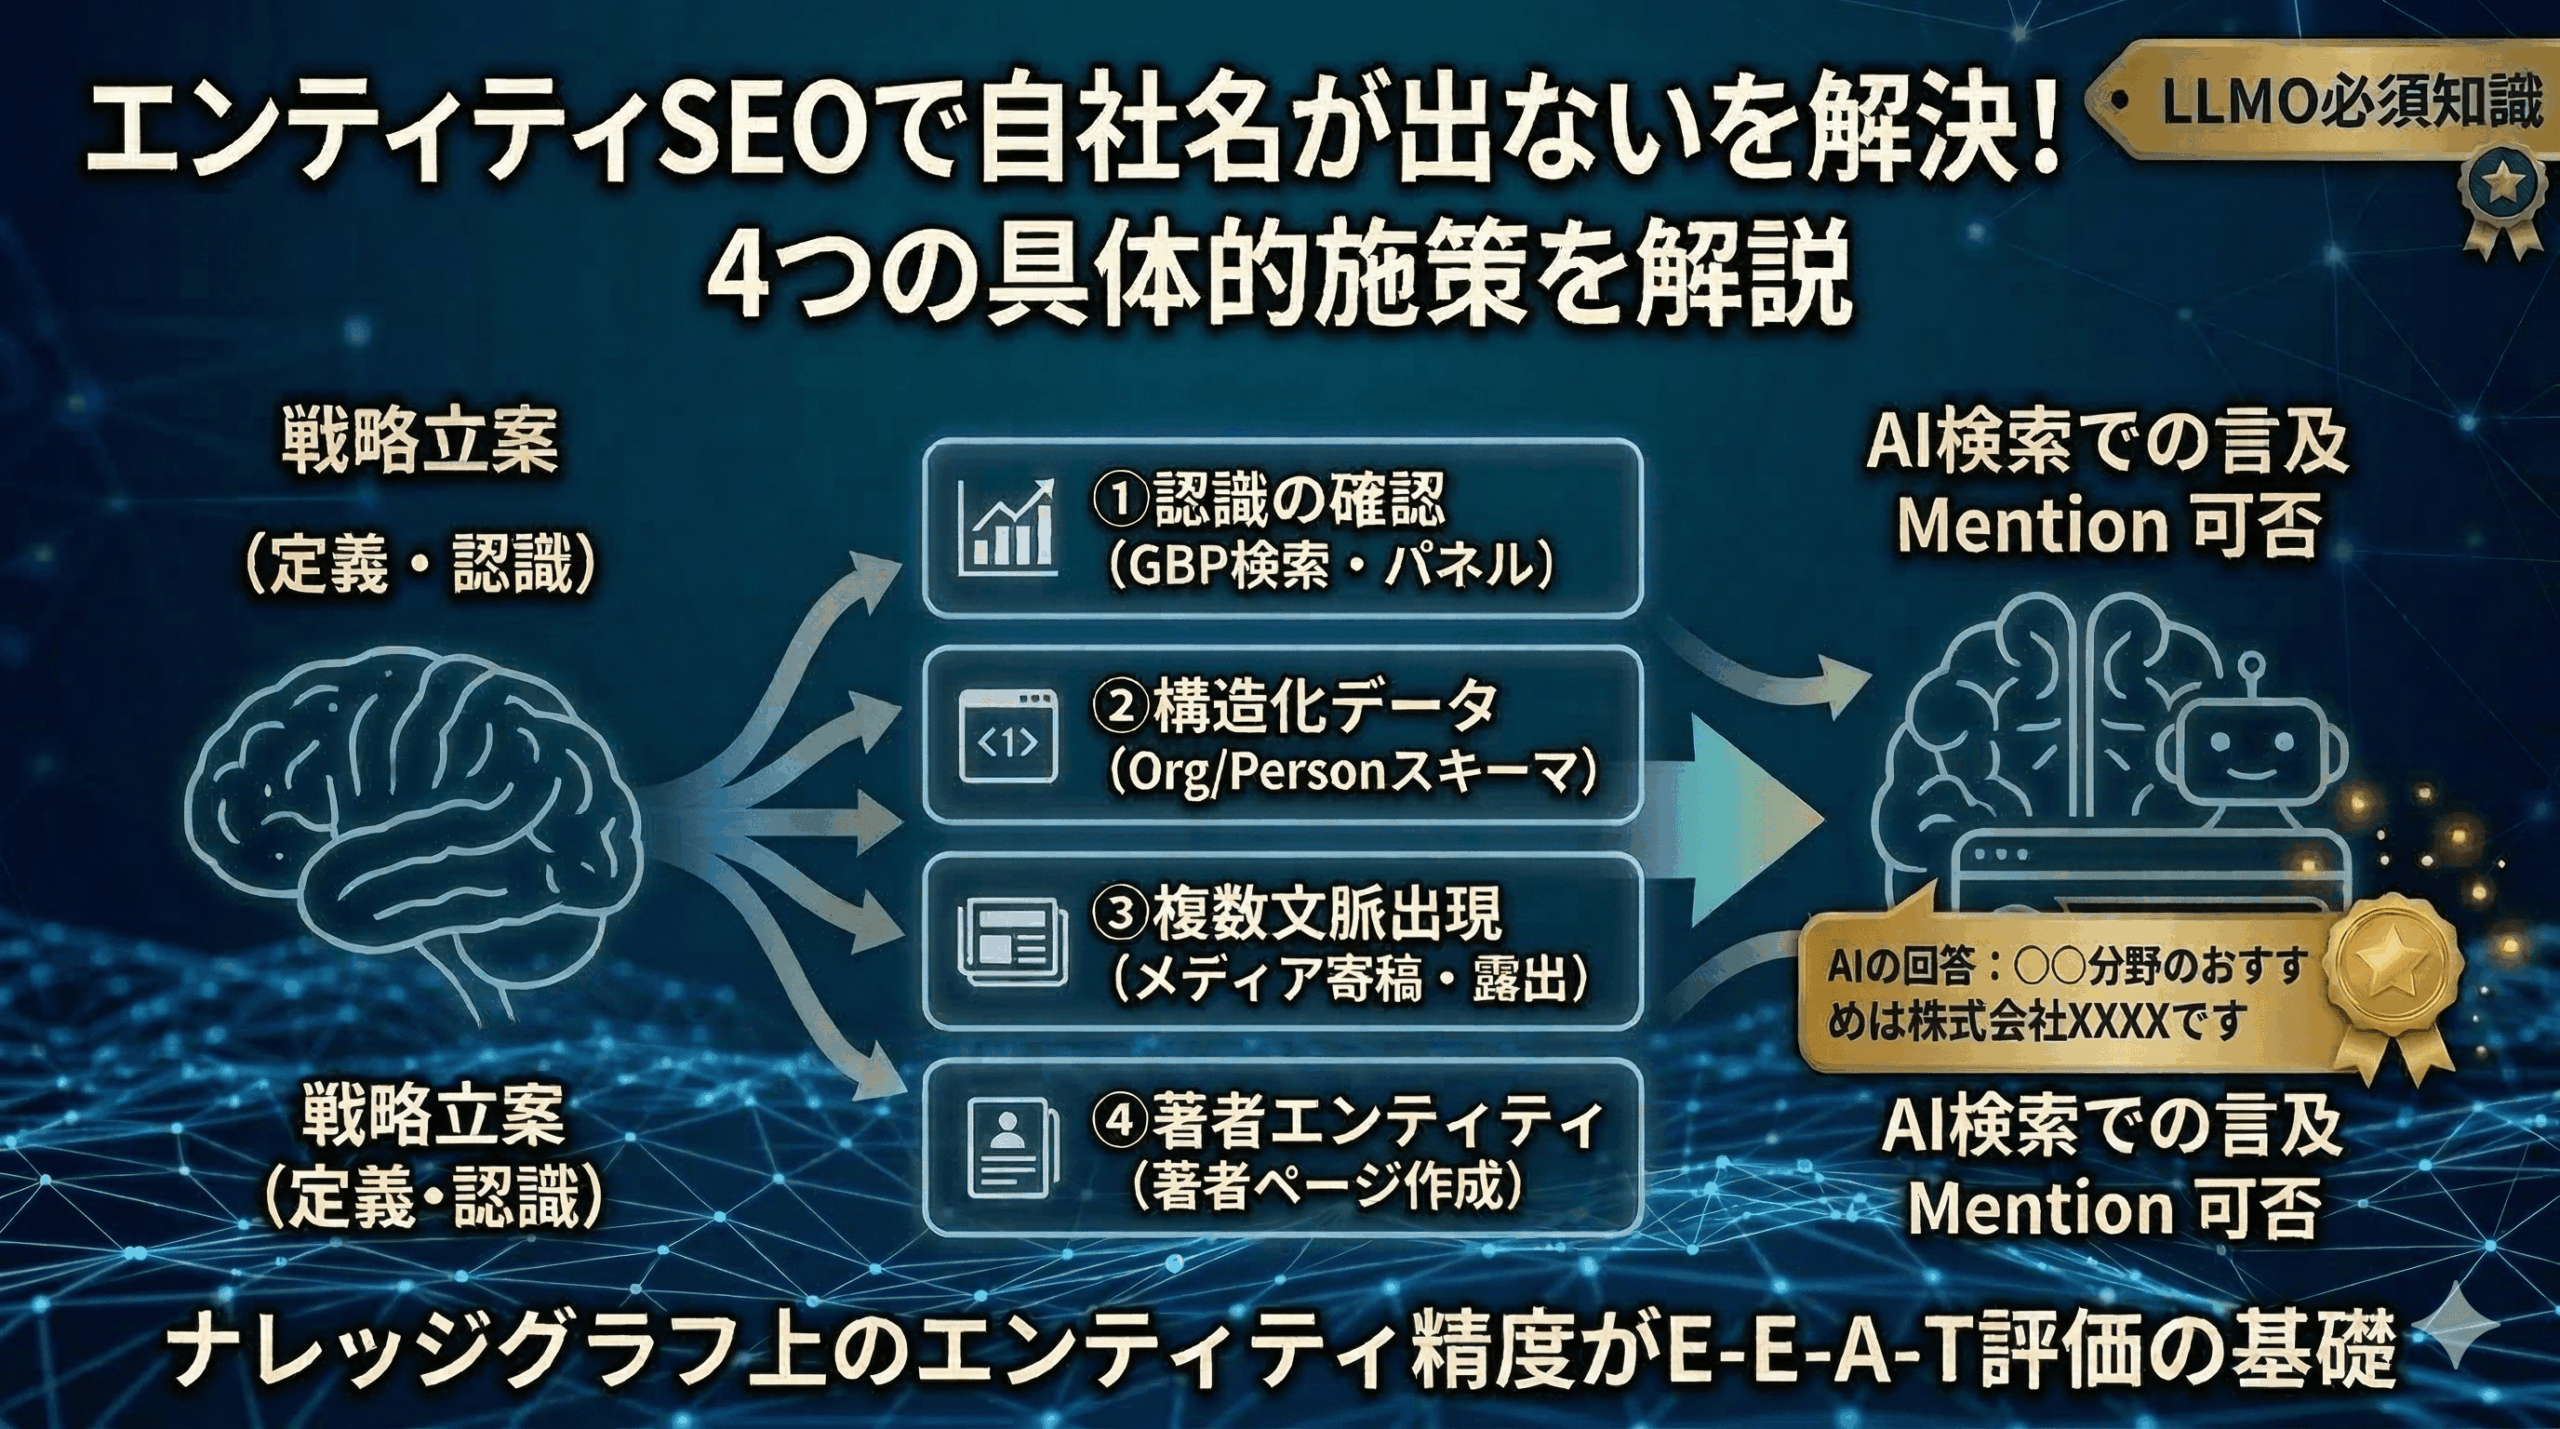
- 構造化データマークアップの完全実装:Schema.orgを用いて、ページ内のコンテンツが「どの組織が」「誰によって書かれ」「何を対象としているのか」を検索クローラーへ明示的に伝達します。
- 権威ある外部データベースとの接続:WikidataやGoogleビジネスプロフィール、公式プレスリリースなどと自社情報を一貫して紐付け、ナレッジグラフ上での信頼度を確立します。
- 共起する関連概念の網羅性:対象トピックを解説する際、専門家であれば当然言及する周辺エンティティを過不足なく盛り込むことで、コンテンツの専門性(E-E-A-T)を機械的に立証します。
AIが回答を自動生成する検索体験(AI Overviewsなど)が主流となる中、検索エンジンに「確固たる実体」として認識されていない情報は、引用ソースとして選ばれにくくなっています。文字列の小手先な最適化から、ブランドや著者という「実体の信頼性構築」へ舵を切ることが不可欠です。
【実践現場のリアル】ER図・ドメイン駆動設計における失敗しない設計思考
システム開発の現場において、エンティティの切り方を誤ると、後々の機能追加やデータ抽出に甚大な負債を残すことになります。特にデータベース設計における実体関連モデル(ERモデル)の構築では、設計者の洞察力が試されます。
ER図属性リレーションを策定する際、現場で最も多発するトラブルが「エンティティと属性の混同」です。
例えば、ECサイトの設計で「顧客テーブル」の中に「配送先住所1」「配送先住所2」というカラム(属性)を安易に設けてしまうケースが挙げられます。一見シンプルに見えますが、顧客が3カ所以上の配送先を登録したいとなった瞬間にテーブル構造の改修が必要になります。この場合、「配送先」という概念そのものを独立したエンティティとして切り出し、顧客エンティティと1対多のリレーションを結ぶのが論理的に正しいアプローチです。
また、ドメイン駆動設計エンティティを扱うアーキテクチャでは、「値オブジェクト(Value Object)」との厳格な区別が求められます。
- Entity:一意の識別子(ID)を持ち、属性値が変わっても「同じもの」として追跡される対象(例:ユーザーアカウント、注文データ)。
- Value Object:属性値そのものが意味を持ち、値が変われば別物となる対象(例:金額、住所、氏名)。
この境界線を曖昧にしたまま実装を進めると、システム全体で意図しないデータの書き換えが発生し、不具合の温床となります。業務の現場で何が一意に特定されるべき「実体」なのかを見極める観察眼こそが、堅牢なシステム構築の礎となります。
【誤解を是正】一般に知られていない盲点とネットの3大誤解
ネット上の解説記事やSNS上では、エンティティに関する極端な解釈や誤解が散見されます。実務で誤った判断を下さないために、代表的な3つの誤解を正しく是正します。
誤解1:キーワードの詰め込みを言い換えたのがエンティティ対策である
「エンティティSEOとは、関連する専門用語を本文中にたくさん散りばめることだ」という認識は明白な誤りです。検索エンジンが見ているのは単語の出現頻度ではなく、「主語・述語・目的語」で構成される知識グラフの正確さと論理関係です。文脈を無視して関連語を詰め込む行為は、スパム判定のリスクを高めるだけであり、本質的な概念評価には一切つながりません。
誤解2:エンティティは「固有名詞」に限定される
有名な人名や企業名、地名だけがエンティティであると誤解されがちですが、抽象概念(例:「量子コンピューティング」「インフレーション」「民主主義」)や、事象・状態(例:「2026年ワールドカップ」「一次面接」)も立派なエンティティです。自社のニッチな独自メソッドやBtoB向け専門サービスであっても、定義を明確にしてWeb上で一貫した情報発信を行えば、検索エンジンに新たな実体として認識させることが可能です。
誤解3:Schema.orgを記述すれば即座に順位が跳ね上がる
構造化データマークアップは、検索エンジンに対して「情報のカンペ」を渡す作業に過ぎません。マークアップされた内容がページ本文の記述と矛盾していたり、外部からの客観的な裏付け(一次ソースや被リンク、サイテーション)が乏しかったりする場合、検索エンジンはその情報をオーソリティとして認定しません。構造化データは必須条件ではあっても、それ単体で順位を押し上げる魔法の杖ではないと理解すべきです。
【プロの結論】導入・学習を今すぐ進めるべき組織と慎重になるべきケース
エンティティ思考へのシフトは極めて強力ですが、すべてのプロジェクトで一律に高度な実装が必要なわけではありません。リソース配分の判断基準を以下に提示します。
▼今すぐエンティティベースの設計・SEOを推進すべきケース:
- 複数拠点を展開する企業や、多種多様なプロダクトを抱える大規模ポータルサイト
- 医療、金融、法律、先端技術など、E-E-A-T(専門性・権威性)が厳格に問われるYMYL領域のメディア
- 長期的な拡張性と保守性が求められる基幹業務システムやSaaSプロダクトの開発
▼過度な最適化を急がず、基礎整備に留めるべきケース:
- 立ち上げたばかりで、まずユーザーのニーズ検証や記事コンテンツの量・質産が最優先となる小規模ブログ
- 1ページで完結するシンプルなキャンペーンLP(過剰なER設計や複雑な構造化マークアップは費用対効果が低い)
【エンティティ と は】に関するよくある質問(FAQ)
Q1:HTMLエンティティ(文字参照)とデータベースのエンティティには何か関係がありますか?
A1:語源としての「実体(Entity)」は同じですが、技術的な意味合いは完全に異なります。HTMLエンティティは「<」や「&」といった特殊記号をブラウザに誤解なく解釈させるためのエスケープコードを指し、データベースのエンティティは「管理対象となるデータのまとまり(テーブル)」を指します。別概念として明確に区別して問題ありません。
Q2:個人サイトや中小企業でもエンティティSEOに取り組む意味はありますか?
A2:極めて大きいです。特に「誰が発信しているのか(著者情報・運営組織)」をSchema.orgを用いて明確に定義することは、大手サイトに対抗するための必須戦略となります。自社の強みとなる固有の専門領域と自社名をナレッジグラフ上で強固に結びつけることで、AI検索時代の露出機会を確保できます。
Q3:ドメイン駆動設計(DDD)におけるエンティティを理解する最短ルートは何ですか?
A3:まずは「IDによる同一性の判定」と「可変性(ミュータブル)」の2点に集中して理解することです。「パスポート番号が同じなら、髪型や住所が変わっても同一人物」とみなすのがEntityであり、「100円玉は別の100円玉と区別せず、金額という値そのものに意味がある」とするのがValue Objectです。この実生活のメタファーをコードに当てはめることで直感的に理解できるようになります。
まとめ:今後の動向と失敗しないための判断基準
「エンティティとは何か」という問いに対する最も本質的な答えは、「世界やシステムの中に存在する、他と区別された固有の概念・実体」です。
データベース設計においては、不整合のない美しい情報構造を築くための最小単位となり、検索エンジンやAI技術においては、文脈と知識を正確に読み解くための結節点(ノード)として機能します。AIの言語処理能力が飛躍的に高度化するこれからの時代、曖昧な単語の羅列ではなく、明確に定義された「エンティティとその関係性」を意識した情報設計ができるかどうかが、開発やマーケティングの成果を大きく左右します。
まずは自社のWebサイトにおいて構造化データを適切に記述すること、あるいは開発中のデータ構造において「何が実体で何が属性なのか」を正確に切り分けることから、実践の一歩を踏み出してみてください。 (出典: エンティティ と は(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
