二項分布が直感でわかる!公式と期待値・分散の導出や近似を徹底解説
データサイエンスの基礎や資格試験において、多くの学習者が最初の関門として直面するのが「二項分布(Binomial Distribution)」です。無味乾燥な数式の羅列に見える確率論も、その背後にあるメカニズムを紐解けば、日常の意思決定やビジネスの現場を支える極めて合理的なツールであることが見えてきます。
統計検定の対策や実務でのデータモデリングにおいて、公式を丸暗記するだけの学習法は応用が効かず、すぐに壁にぶつかります。本稿では、コイン投げのような誰にでもわかる具体例を出発点に、公式の成立根拠から期待値・分散のスマートな導出、さらにポアソン分布や正規分布への近似条件まで、本質を徹底的に解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:二項分布は「成功・失敗」の2択かつ各試行が独立な現象を扱う確率モデルであり、公式は「場合の数×確率」の積で直感的に組み立てられる
- 要点2:期待値 $np$ や分散 $np(1-p)$ は、1回のベルヌーイ試行の線形性を理解することで、複雑なシグマ計算を一切使わずに導出できる
- 要点3:試行回数 $n$ と生起確率 $p$ の大きさによって、ポアソン分布(希少事象)や正規分布(十分な試行数)へと美しく近似が成立する
【直感解説】二項分布の公式や期待値・分散の計算でつまずく理由と本質
二項分布の公式や期待値・分散の計算でつまずいていませんか?なぜその式になるのか、コイン投げなどの具体例を用いれば驚くほど直感的に理解できます。ポアソン分布・正規分布との決定的な違いまで、知っておくべき重要ポイントを余さず整理していきます。
教科書を開くと現れる以下の確率質量関数を見て、強い拒絶反応を示す学習者は少なくありません。
$P(X = k) = {}_n\mathrm{C}_k p^k (1-p)^{n-k} \quad (k = 0, 1, 2, \dots, n)$
この数式を前にして挫折する最大の原因は、数式のパーツを「記号の塊」として暗記しようとする点にあります。この式は、実は「特定の並び順で起きる確率」に「その並び順のパターン数」を掛け算しているだけのシンプルな構造に過ぎません。
たとえば、「歪みのないコインを5回投げたとき、表がちょうど3回出る確率」を考えてみましょう。表が出る確率を $p = 0.5$、裏が出る確率を $1-p = 0.5$ とします。
「表・表・表・裏・裏」という特定の順番で出る確率は、$0.5^3 \times (1-0.5)^2$ です。しかし、表が3回出る順番はこれだけではありません。「表・裏・表・裏・表」や「裏・裏・表・表・表」など複数の並び順が存在します。その組み合わせの総数こそが、高校数学で学ぶ組み合わせ記号 ${}_5\mathrm{C}_3 = 10$ 通りです。
つまり、公式の構成要素を分解すると以下の2点に集約されます。
- ${}_n\mathrm{C}_k$:$n$ 回のなかから「成功する $k$ 回」を選ぶ組み合わせパターン数
- $p^k (1-p)^{n-k}$:成功が $k$ 回、失敗が $n-k$ 回連続して起こる1パターンあたりの生起確率
この2つを掛け合わせることで、二項分布の公式は自然に導かれます。また、確率変数が特定の値を取る確率を与えるこの関数を、離散型確率変数の文脈で「確率質量関数」と呼びます。
ここで二項分布をわかりやすく整理するために欠かせないのが、現象が満たすべき前提です。統計学において、結果が「成功/失敗」「表/裏」「陽性/陰性」の2通りしか存在しない試行をベルヌーイ試行と呼びます。二項分布が成立するための条件は、以下の3点に限られます。
- 各試行の結果が2値のみであること
- 各回の試行が互いに影響を与えないこと(試行の独立性)
- 各試行における成功確率 $p$ が常に一定であること
なお、似た用語である「二項定理との違い」について疑問を抱く方も多いはずです。数学的な本質を突けば、二項定理は多項式 $(a + b)^n$ を展開する代数的な恒等式であり、二項分布はその展開式において $a = p, b = 1-p$(合計が1)とおくことで、全事象の確率の総和が $(p + (1-p))^n = 1^n = 1$ になる性質を利用した確率モデルです。両者は数式として強固な双子関係にありながら、扱う目的が「式の展開」か「現象の確率モデリング」かという明確な違いを持っています。
期待値と分散の計算完全マスター|公式の暗記を卒業する数学的メカニズム
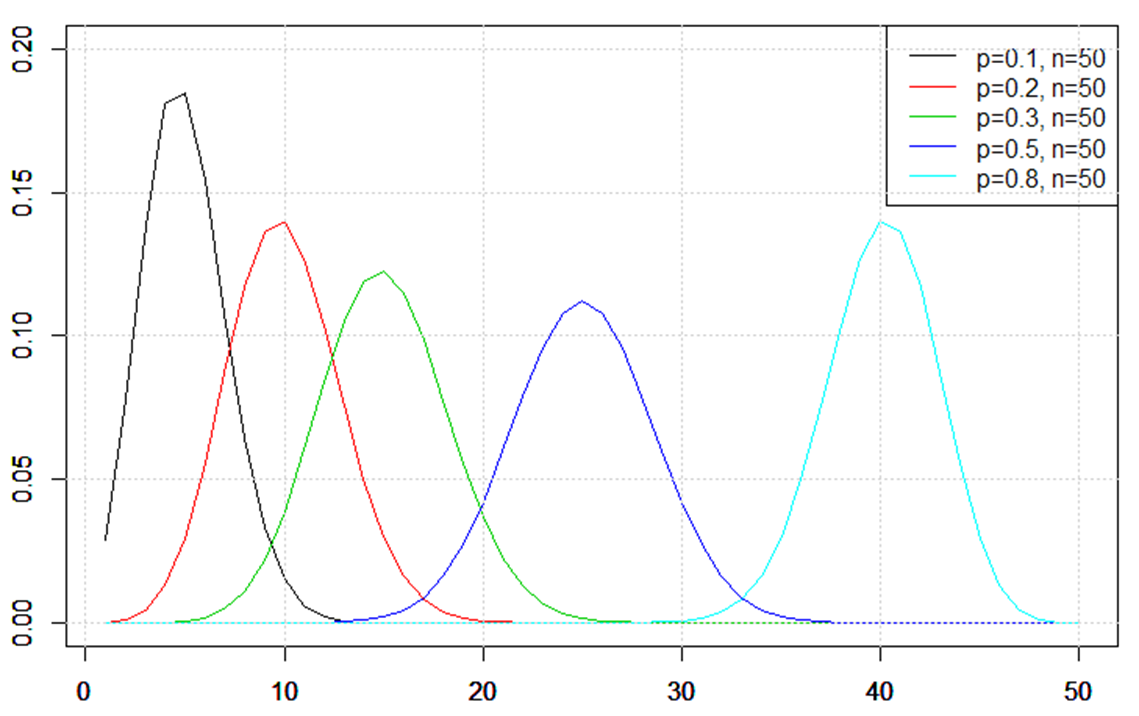
二項分布 $B(n, p)$ に従う確率変数 $X$ について、平均的に何回成功が見込めるかを示す「期待値 $E(X)$」と、データの散らばり度合いを示す「分散 $V(X)$」は、極めて簡潔な公式で表されます。
- 期待値:$E(X) = np$
- 分散:$V(X) = np(1-p)$
この簡潔な結果に対し、定義通りにシグマ記号を使って $\sum k \cdot {}_n\mathrm{C}_k p^k (1-p)^{n-k}$ をゴリゴリ計算しようとすると、微分や添字のずらしといった技巧的な式変形に追われ、本質を見失いがちです。しかし、「和の期待値は期待値の和」という期待値の線形性を活用すれば、一瞬で直感的な理解に到達できます。
コイン投げを例に、1回だけコインを投げるミニマムなベルヌーイ試行を考えます。表が出たら1、裏が出たら0をとる確率変数を $X_1$ とすると、期待値と分散は次のように求まります。
1回の試行における期待値:
$E(X_1) = 1 \times p + 0 \times (1-p) = p$
1回の試行における分散:
分散の定義式 $V(X_1) = E(X_1^2) - \{E(X_1)\}^2$ を用います。$X_1^2$ も1または0しか取らないため、$E(X_1^2) = 1^2 \times p + 0^2 \times (1-p) = p$ となります。したがって、
$V(X_1) = p - p^2 = p(1-p)$
$n$ 回の独立な試行全体の成功回数 $X$ は、各回の結果の総和に過ぎません。すなわち、$X = X_1 + X_2 + \dots + X_n$ です。
期待値の線形性により、互いに独立であるかどうかにかかわらず、和の期待値はそれぞれの期待値の合計になります。
$E(X) = E(X_1) + E(X_2) + \dots + E(X_n) = p + p + \dots + p = np$
さらに、各試行が互いに「独立」であるため、分散も単純に足し合わせることができます。
$V(X) = V(X_1) + V(X_2) + \dots + V(X_n) = p(1-p) + p(1-p) + \dots + p(1-p) = np(1-p)$
たとえば、成功確率が20%($p=0.2$)の営業テレアポを100回($n=100$)実施した場合、獲得できる成約件数の期待値は $100 \times 0.2 = \mathbf{20\text{件}}$ と直感通りになります。そのばらつきを示す分散は $100 \times 0.2 \times 0.8 = \mathbf{16}$ であり、標準偏差(分散の正の平方根)は $\sqrt{16} = \mathbf{4\text{件}}$ と瞬時に計算可能です。
【徹底比較】二項分布・ポアソン分布・正規分布の違いと近似条件
実務や試験対策において避けて通れないのが、「いつ二項分布をそのまま使い、いつ他の分布で近似するのか」という判断基準です。試行回数 $n$ が膨大になると、${}_n\mathrm{C}_k$ の組み合わせ計算は天文学的な数値となり、コンピュータでもオーバーフローを引き起こします。そこで用いられるのが「ポアソン分布近似」と「正規分布近似」です。
3つの確率分布の特性と近似の目安について、以下の比較表に体系化しました。
| 項目 | 詳細・数値データ | 一般的な基準・相場 | 編集部の見解・評価 |
|---|---|---|---|
| 二項分布 (基本形) | 離散型確率変数 パラメータ:$n, p$ 平均:$np$ 分散:$np(1-p)$ | 試行回数 $n$ が数十回程度の比較的小規模な事象 | 理論の出発点であり厳密解を出す基本。計算負荷が高まる大規模データでは近似の適用を検討すべき。 |
| ポアソン分布 (稀な現象への近似) | 離散型確率変数 パラメータ:$\lambda = np$ 平均:$\lambda$ 分散:$\lambda$ | $n \ge 50$ かつ $p \le 0.1$ (または $np \le 5$ 程度の極小確率) | 「少数の法則」と呼ばれる。Webサーバーのエラー発生数や工場の欠陥品検出など、めったに起きない事象に最適。 |
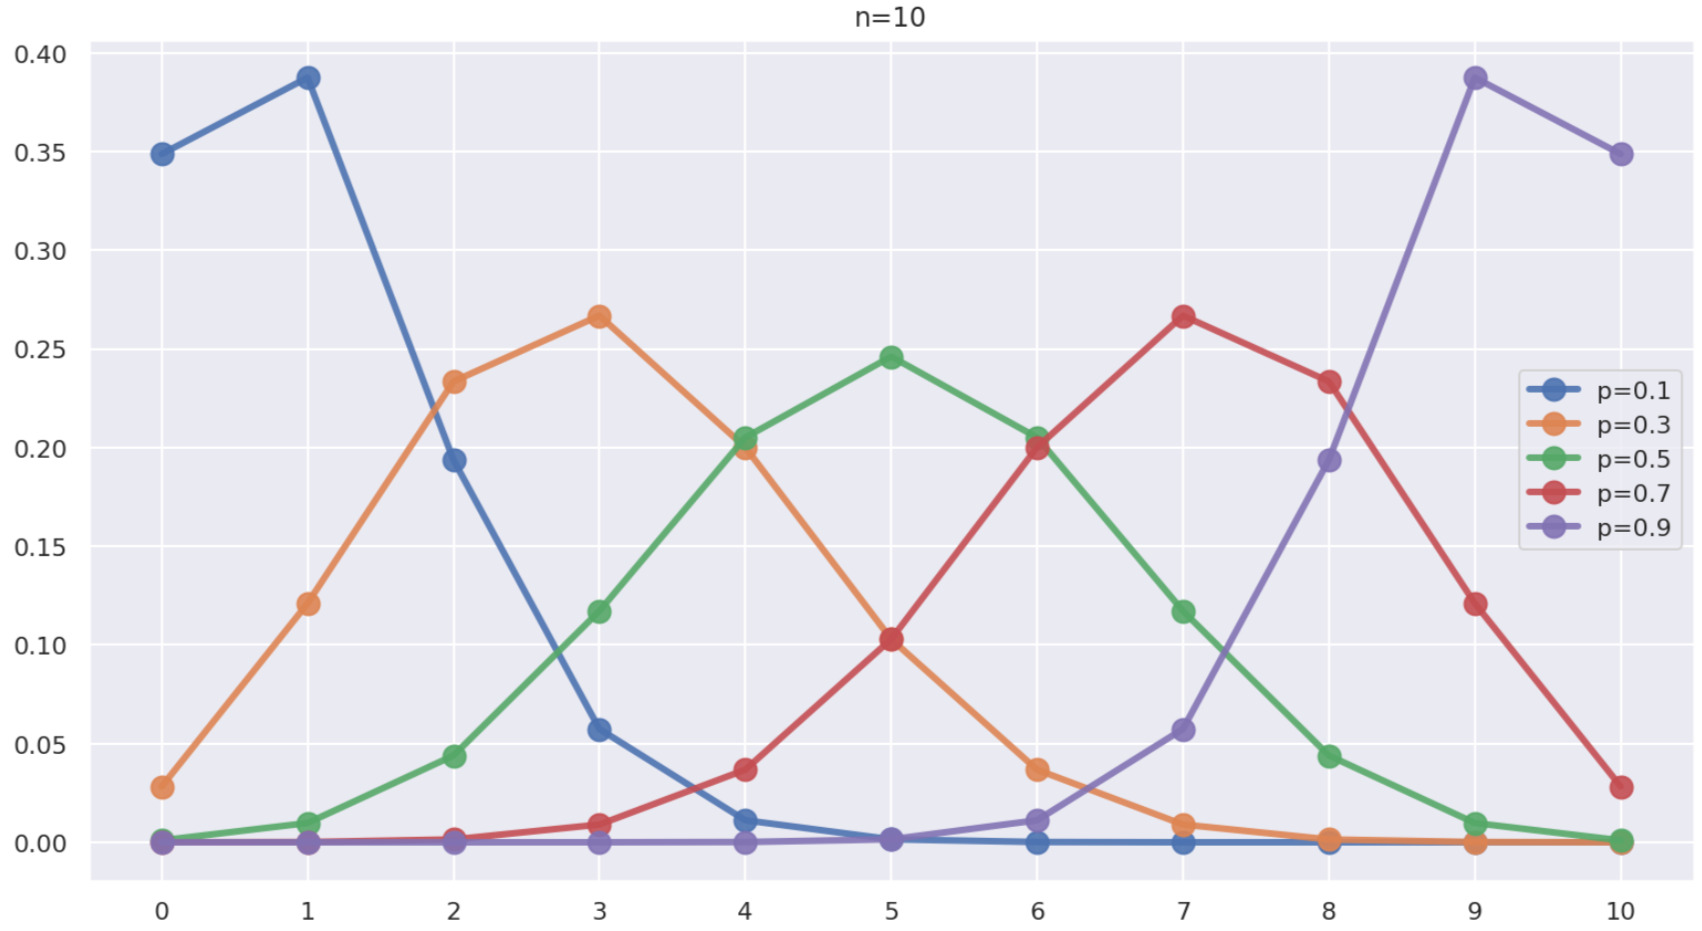
| 正規分布 (大規模試行への近似) | 連続型確率変数 パラメータ:$\mu = np$ $\sigma^2 = np(1-p)$ | $np \ge 5$ かつ $n(1-p) \ge 5$ (より厳格には各10以上) | ド・モアブル=ラプラスの定理に基づく。左右対称の美しい釣鐘型になり、標準化(Z値化)による確率計算が極めて容易。 |
ポアソン分布への近似は、試行回数 $n$ が非常に大きく、かつ成功確率 $p$ が極めて小さい場合に成立します。パラメータは平均発生数 $\lambda = np$ の1つだけに集約され、計算が劇的にシンプルになります。
一方、正規分布への近似は中心極限定理の具現化でもあり、成功回数・失敗回数の期待値がいずれも5以上であれば実用的な精度で二項分布を連続型の正規分布 $N(np, np(1-p))$ で代用できます。ただし、離散型から連続型へ近似する際は、区間を $\pm 0.5$ 広げて補正する「連続性の補正(半整数補正)」が必要になる点に留意してください。
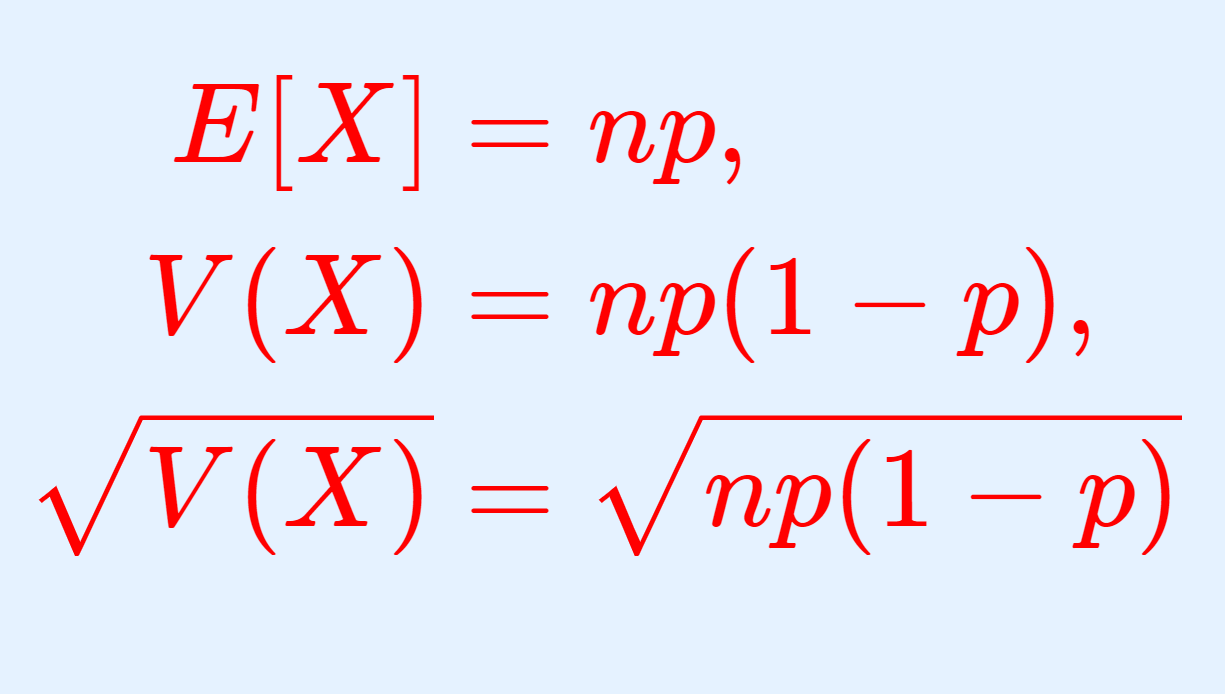
【実戦対策】統計検定合格へ導く例題と解き方&エクセルでの計算手順
ここからは、統計検定3級〜2級レベルの試験対策および業務実務を想定し、二項分布の例題と解き方を実践形式で確認していきます。
ある製造ラインにおいて、製品に欠陥が生じる確率は $5\%$($p = 0.05$)であることが知られている。このラインから無作為に $10$ 個の製品を抽出したとき($n = 10$)、欠陥品がちょうど $2$ 個含まれる確率を求めよ。
【解法ステップ】
まず、パラメータを整理します。試行回数 $n = 10$、生起確率 $p = 0.05$、求める成功回数 $k = 2$ です。
公式に当てはめると、次の式になります。
$P(X = 2) = {}_{10}\mathrm{C}_2 \times (0.05)^2 \times (1 - 0.05)^{10 - 2}$
- 組み合わせの計算:${}_{10}\mathrm{C}_2 = \frac{10 \times 9}{2 \times 1} = 45$
- 確率の計算:$(0.05)^2 = 0.0025$
- 非生起確率の計算:$(0.95)^8 \approx 0.6634$
これらを掛け合わせると、
$P(X = 2) = 45 \times 0.0025 \times 0.6634 \approx \mathbf{0.0746 \quad (約7.46\%)}$
となり、約7.5%の確率で欠陥品が2個発生することが論理的に導き出せます。
実務やレポート作成において、手計算を行う必要はもちろんありません。表計算ソフトでの二項分布のエクセル計算には、標準関数の BINOM.DIST を使用します。
=BINOM.DIST(成功数, 試行回数, 成功率, 関数形式)
第4引数の「関数形式」には、論理値を指定します。
- FALSE(または 0):指定した成功数そのものの確率(確率質量関数)を算出。上記の例題なら
=BINOM.DIST(2, 10, 0.05, FALSE)と入力すると「0.074635...」が返されます。 - TRUE(または 1):0からその成功数までの「累積確率」を算出。「欠陥品が2個以下である確率」を求める場合は
=BINOM.DIST(2, 10, 0.05, TRUE)と指定します。
実務の品質管理やA/Bテストの検証では、「〇回以下である確率(累積確率)」を算出するケースが圧倒的に多いため、TRUEとFALSEの使い分けは確実に身につけておくべき必須テクニックです。
一般に知られていない盲点と現場の誤解|データ分析で犯しやすいミス
二項分布は非常に扱いやすいモデルである反面、実務データ分析の現場では重大な誤用が後を絶ちません。最も頻繁に見られる初歩的かつ致命的なミスが、「非復元抽出」に対する無批判な二項分布の適用です。
たとえば、社員数30名の部署からくじ引きで委員を3名選出する場合、1人選ばれるごとに全体の母集団が減少し、次の人が選ばれる確率が変化します。これは試行が独立ではないため、二項分布の成立条件を満たしていません。このようなケースで本来使うべきは超幾何分布です。
母集団のサイズが数十万〜数千万規模(Webサイトのアクセス数や国政選挙の世論調査など)であれば、非復元抽出であっても母集団に対する抽出割合が極めて小さいため、二項分布と見なして実用上全く問題ありません。しかし、母集団の $10\%$ を超えるような小規模グループからサンプルを抜き出す場面で二項分布を使うと、分散を過大に見積もってしまうリスクがあります。
もうひとつの落とし穴は、「確率の不均一性」を無視したモデリングです。広告のクリック率(CTR)を二項分布で検証する際、ユーザーの属性(時間帯、デバイス、興味関心)によって本来クリック確率 $p$ は異なっています。全体を一括してひとつの $p$ で二項分布に当てはめると、現実のデータが二項分布の理論分散よりも大きくばらつく「過分散(Overdispersion)」という現象に直面します。この場合、混合分布である負の二項分布やロジスティック回帰モデルへのステップアップが求められます。
【プロの結論】二項分布の学び方|おすすめできる人・慎重になるべき人の判断基準
確率統計の世界において、二項分布は「離散分布の王様」であり、すべての基礎が詰まっています。しかし、個々人の目的やバックグラウンドによって、学習のアプローチは明確に分けるべきです。
- 統計検定2級以上の取得を目指している
- データサイエンティストとしてアルゴリズムをゼロから実装したい
- 確率母関数や積率母関数を使った理論統計学の体系を学びたい
- マーケティング施策の成否やA/Bテストを素早く判定したいビジネスパーソン
- 数式アレルギーがあり、シグマ記号を見ただけで学習が止まってしまう初学者
- 品質管理の実務で合格/不合格の基準値を早急に算出する必要がある現場担当者
数式を完全に証明できなくても、二項分布の「前提条件(独立な2値データ)」と「パラメータ($n$ と $p$)」の意味さえ正しく把握していれば、現代のデータ分析ツールを十二分に乗りこなすことができます。背伸びをせず、自身の目的に合った解像度で付き合うことが、統計学で挫折しないための最大の秘訣です。
【二項分布】に関するよくある質問(FAQ)
Q1:二項分布とポアソン分布は実務でどのように使い分ければよいですか?
A1:着目している現象の「試行回数(分母)」が明確に定義できるかどうかで判断します。たとえば「100人にアンケートして何人賛成したか」は分母が100と決まっているため二項分布を用います。一方、「1時間のあいだにコールセンターに何件電話がかかってきたか」「1ヶ月に交通事故が何件起きたか」のように、試行回数の上限を定義しにくく、滅多に起きない事象の発生頻度を扱う場合はポアソン分布を適用するのが定石です。
Q2:エクセルで二項分布の累積確率を求める際、端数は含まれますか?
A2:はい、指定した数値を含みます。たとえば =BINOM.DIST(3, 10, 0.5, TRUE) と入力した場合、「3回以下(0回、1回、2回、3回)」の確率の合計が返されます。もし「3回未満(0回、1回、2回)」の確率を求めたい場合は、第1引数に 2 を指定する必要があるため、境界値の不等号(「以下」か「未満」か)には注意が必要です。
Q3:統計検定対策として、二項分布のどこまでを重点的に覚えるべきですか?
A3:統計検定3級であれば「公式を用いた基本的な確率の計算」と「期待値 $np$、分散 $np(1-p)$ の計算」ができれば十分合格点に届きます。2級を目指す場合は、これらに加えて「正規分布近似(中心極限定理の適用)」「ポアソン近似の条件」、そして比率の仮説検定(Z検定)への展開までを確実に押さえておく必要があります。
まとめ:今後の動向と失敗しないための判断基準
AIや機械学習の技術が急速に発展する現代においても、確率統計の土台である二項分布の重要性が揺らぐことはありません。どれほど高度な深層学習モデルであっても、その根底にある分類問題の損失関数(バイナリクロスエントロピーなど)は、ベルヌーイ試行と二項分布の対数尤度という同一の思想から設計されています。
二項分布を学ぶ上で最も重要なのは、記号に惑わされず「現象をモデル化する直感」を掴むことです。「独立な試行か?」「確率は一定か?」「試行回数は十分に大きいか?」という問いかけを持つことで、誤った統計モデリングを未然に防ぎ、データに基づいた精度の高い意思決定を下すことが可能になります。本稿で整理した原則を手がかりに、ぜひ実務や資格学習の現場で二項分布を自在に活用してください。 (出典: 二 項 分布(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
