サンプルデータ(施策前後のスコア)
同一の被験者に対して「投薬前と投薬後」や「施策導入前と導入後」といった前後比較を行う際、どの統計的仮説検定を選択すべきか迷うデータ分析者は少なくありません。一般的に広く用いられるのは「対応のあるt検定」ですが、データが正規分布に従っていない場合やサンプルサイズが限られている場合に適用すると、誤った判定(第1種の過誤や検出力の低下)を引き起こす危険性があります。
そこで必須となるのが、ノンパラメトリック検定手法の代表格であるウィルコクソンの符号順位検定(Wilcoxon signed-rank test)です。本稿では、対応のあるt検定やマン・ホイットニーのU検定との決定的な違いから、正規性の検定(シャピロ・ウィルク検定)を用いた適切な検定選択フロー、EZR・Python・R言語・SPSS・Excelでの具体的な解析手順、さらにはp値の解釈と効果量の算出方法まで、2026年の実務基準に即して徹底的に解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:ウィルコクソンの符号順位検定は「対応のある2群」を比較するノンパラメトリック検定であり、差のデータが正規分布に従わない場合に最適な手法です。
- 要点2:独立した2群を比べる「マン・ホイットニーのU検定」や、正規分布を前提とする「対応のあるt検定」との違いを理解し、シャピロ・ウィルク検定等で事前に前提条件を検証することが不可欠です。
- 要点3:有意差判定(p値)のみに依存せず、効果量(r)を併せて報告することで、研究論文やビジネス分析における結論の信頼性を担保できます。
【基礎解説】ウィルコクソンの符号順位検定とは?どんな時に使うべきか
ウィルコクソンの符号順位検定(ウィルコクソンの符号付き順位検定)は、1945年に統計学者フランク・ウィルコクソン(Frank Wilcoxon)によって考案された統計的仮説検定です。主に「対応のある2群の比較(paired comparison)」において、2組の測定値間に有意な差が存在するかどうかを判定するために用いられます。
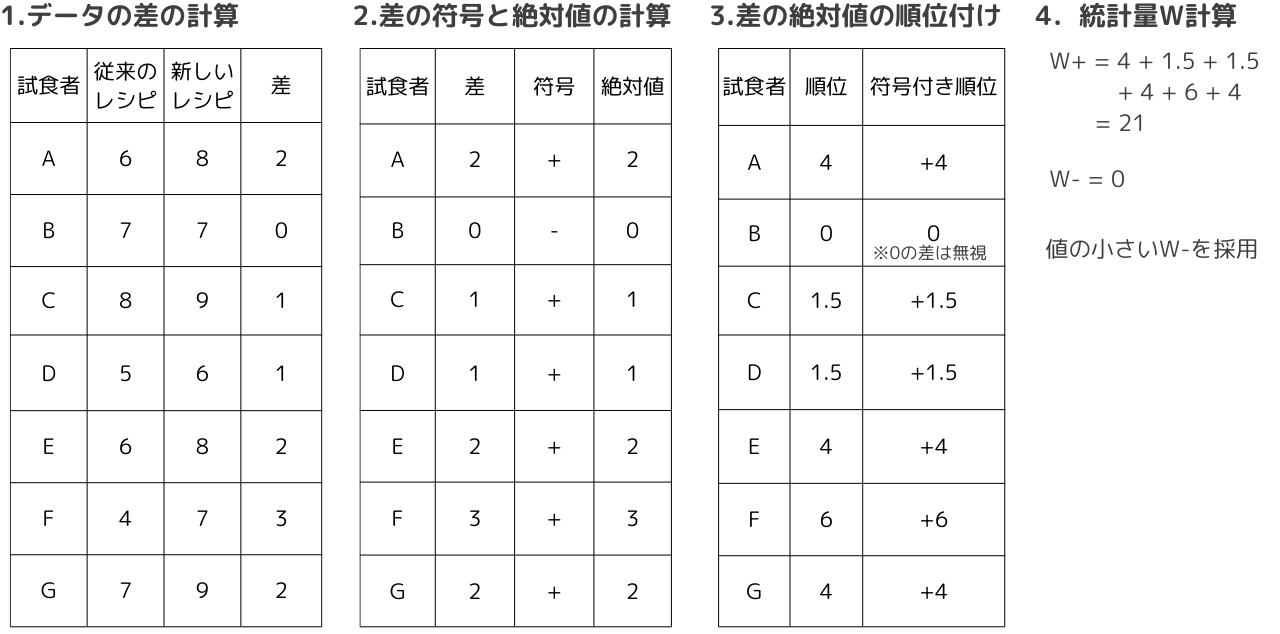
本検定の最大の特徴は、測定値そのものの絶対的な数値(平均値など)を直接比較するのではなく、各ペアの「差」の符号(プラスかマイナスか)と、その差の絶対値の「順位(ランク)」に基づいて検定統計量を算出する点にあります。この仕組みにより、極端な外れ値(異常値)の影響を大幅に抑えながら、順位尺度や非正規分布の連続データを堅牢(ロバスト)に評価できます。
マン・ホイットニーのU検定との違い
初学者が最も混同しやすいのが「マン・ホイットニーのU検定(ウィルコクソンの順位和検定)」との使い分けです。名称に同じ「ウィルコクソン」が含まれるため混乱を招きがちですが、検定対象となるデータの構造が根本的に異なります。
- ウィルコクソンの符号順位検定:同一の被験者を対象にした「事前・事後」の測定データなど、対応のある(paired)2群の比較に用いる。
- マン・ホイットニーのU検定:「男性群と女性群」「AクラスとBクラス」のように、互いに独立した別個の被験者グループである対応のない(unpaired / independent)2群の比較に用いる。
分析対象の2つのデータ列において、行ごとに「同一人物」「同一の実験個体」「同一のマッチングペア」という一対一の結びつきがある場合は、迷わず符号順位検定を選択します。
対応のあるt検定との決定的な違い|正規性の検定と使い分け基準
対応のある2群を比較する際、パラメトリック検定である「対応のあるt検定(paired t-test)」とノンパラメトリック検定である「ウィルコクソンの符号順位検定」のどちらを選択すべきかは、データの分布特性によって決定されます。
判断の要となるのが正規性の検定(シャピロ・ウィルク検定:Shapiro-Wilk test)です。対応のあるt検定は「2群の差の分布が正規分布に従うこと」を前提としています。もしシャピロ・ウィルク検定を行って有意水準(通常 p < 0.05)となり、差の正規性が棄却された場合は、ウィルコクソンの符号順位検定を採用するのが統計学的な鉄則です。
| 検定手法 | 対象データの関係性 | データが満たすべき前提条件 | 比較する代表値・評価指標 |
|---|---|---|---|
| 対応のあるt検定 | 対応あり(同一対象の前後など) | 差のデータが正規分布に従う(間隔尺度・比率尺度) | 平均値の差(差の平均値が0か否か) |
| ウィルコクソンの符号順位検定 | 対応あり(同一対象の前後など) | 正規分布を仮定しない(順序尺度、歪んだ連続変数) | 差の符号付き順位和(中央値・分布のシフト) |
| マン・ホイットニーのU検定 | 対応なし(完全に独立した2群) | 正規分布を仮定しない(独立した観測値) | 全体の順位和(中央値の差・分布の位置) |
アンケート調査で頻用される5段階のリッカート尺度(1:全く思わない 〜 5:非常に思う)などの順序尺度データは、厳密には数値間の間隔が均等とは言えないため、平均値を前提とするt検定ではなく、ウィルコクソンの符号順位検定を適用することが推奨されます。
【実践】主要ツール別の解析手順と実装コード
実際の研究やビジネスの現場で頻繁に利用される5大ツール(EZR、Python、R言語、SPSS、Excel)におけるウィルコクソンの符号順位検定の実行手順を解説します。
1. 医療統計で広く使われる「EZR」での操作手順
自治医科大学が開発・公開している無料の統計ソフト「EZR(Easy R)」は、医学・看護・リハビリテーション分野の論文執筆で極めて高いシェアを誇ります。
- ステップ1:データを読み込み、「統計解析」メニューをクリック。
- ステップ2:「ノンパラメトリック検定」→「対応のある2群の比較(ウィルコクソンの符号付順位検定)」を選択。
- ステップ3:比較したい「変数1(例:治療前スコア)」と「変数2(例:治療後スコア)」を選択し、「OK」をクリック。
- ステップ4:出力画面(ログウィンドウ)に表示される検定統計量(V値)と p値(p-value) を確認。
2. Python(scipy.stats.wilcoxon)による実装
データサイエンス環境でPythonを用いる場合、scipy.stats モジュールの wilcoxon 関数を利用します。
import numpy as np from scipy import stats before = np.array([12, 15, 14, 18, 19, 13, 16, 20, 15, 17]) after = np.array([14, 18, 13, 22, 24, 15, 19, 25, 18, 21]) # ウィルコクソンの符号順位検定を実行(両側検定) res = stats.wilcoxon(before, after, alternative='two-sided') print(f"検定統計量: {res.statistic}") print(f"p値: {res.pvalue:.5f}") 3. R言語(wilcox.test)による実装
標準的なR言語環境では、組み込みの wilcox.test() 関数を使用し、引数に paired = TRUE を指定します。
# データの準備 before <- c(12, 15, 14, 18, 19, 13, 16, 20, 15, 17) after <- c(14, 18, 13, 22, 24, 15, 19, 25, 18, 21) # 対応のある検定を実行 result <- wilcox.test(before, after, paired = TRUE) print(result) 4. SPSSでの実行手順
IBM SPSS Statisticsでは、GUIメニューから数クリックで実行が可能です。
- メニュー操作:「分析」→「ノンパラメトリック検定」→「レガシーダイアログ」→「2組の対応サンプルの検定」を選択。
- 変数の指定:検定対(ペア)に「変数1」と「変数2」を投入。
- 検定の種類:「ウィルコクソン(Wilcoxon)」にチェックを入れて「OK」を実行。
5. Excelでの算出アプローチ
Excelには本検定を一発で出力する単一関数(例:T.TESTのような関数)は用意されていません。そのため、以下の手順でワークシート上に計算式を組み立てます。
- 列Aと列Bの「差(A - B)」を計算。
- 差が「0」の行を除外(または適切に処理)。
- 差の「絶対値」を
ABS()関数で求め、RANK.AVG()関数で順位を付与。 - 差の符号がプラスの順位和($W^+$)とマイナスの順位和($W^-$)を
SUMIF()関数で集計。 - 小さい方の順位和を検定統計量 $T$ とし、サンプル数に応じた臨界値表を参照するか、正規近似計算(標準得点 $Z$ から
NORM.S.DIST()を使用)によってp値を導出。

有意差判定p値の解釈と「効果量」の重要性
検定結果を出力した際、多くの分析者が「p値が0.05を下回ったかどうか」のみに目を奪われがちです。しかし、近年の国際的な学術誌や統計ガイドラインでは、有意差判定p値の解釈と同時に、効果量(Effect Size)の算出・記載が強く求められています。
なぜなら、p値はサンプルサイズ(観測数)に強く依存するためです。サンプル数が極めて膨大であれば、実質的には臨床的・実務的な意味を持たないごくわずかな差であっても「p < 0.001」と有意になってしまいます。逆に、サンプル数が少ない場合は、実際には大きな差が存在していても有意差を検出できない(検出力不足)リスクが生じます。
ウィルコクソンの符号順位検定における効果量(r)の算出式
符号順位検定における標準的な効果量 $r$ は、検定で得られた標準正規分布の統計量 $Z$ と、観測ペア数(またはデータ総数)から以下のように計算されます。
$$r = \frac{|Z|}{\sqrt{N}}$$
ここで $N$ は観測ペアの総数(前後ペアなら被験者数)です。効果量 $r$ の目安としては、一般的にコーエン(Cohen)の基準に準じ、0.1以上で小(Small)、0.3以上で中(Medium)、0.5以上で大(Large)と解釈されます。論文や報告書を作成する際は、「$p = 0.012, r = 0.45$」のように両方の指標を併記することで、結果の説得力が格段に高まります。
【実態検証】データ分析で陥りがちな盲点とネットの誤解
統計解説サイトや実務現場において、ウィルコクソンの符号順位検定に関する誤解や見落とされがちな落とし穴が散見されます。特に注意すべき2大論点を検証します。
誤解1:前後で差が「0」のデータを安易に削除してよいのか?
被験者の「施策前」と「施策後」の数値が完全に一致し、差が「0(ゼロ)」となるケースは実務上多発します。この「ゼロ差(zero differences)」の処理方法には複数の学説・アルゴリズムが存在します。
- Wilcoxon法(古典的手法):差が0のペアをデータセットから完全に除外して有効サンプル数 $n$ を減らし、残りのデータで順位付けを行う。
- Pratt法:差が0のペアも含めて全体の順位を付けた後、ゼロに割り当てられた順位を計算から除外または調整する。
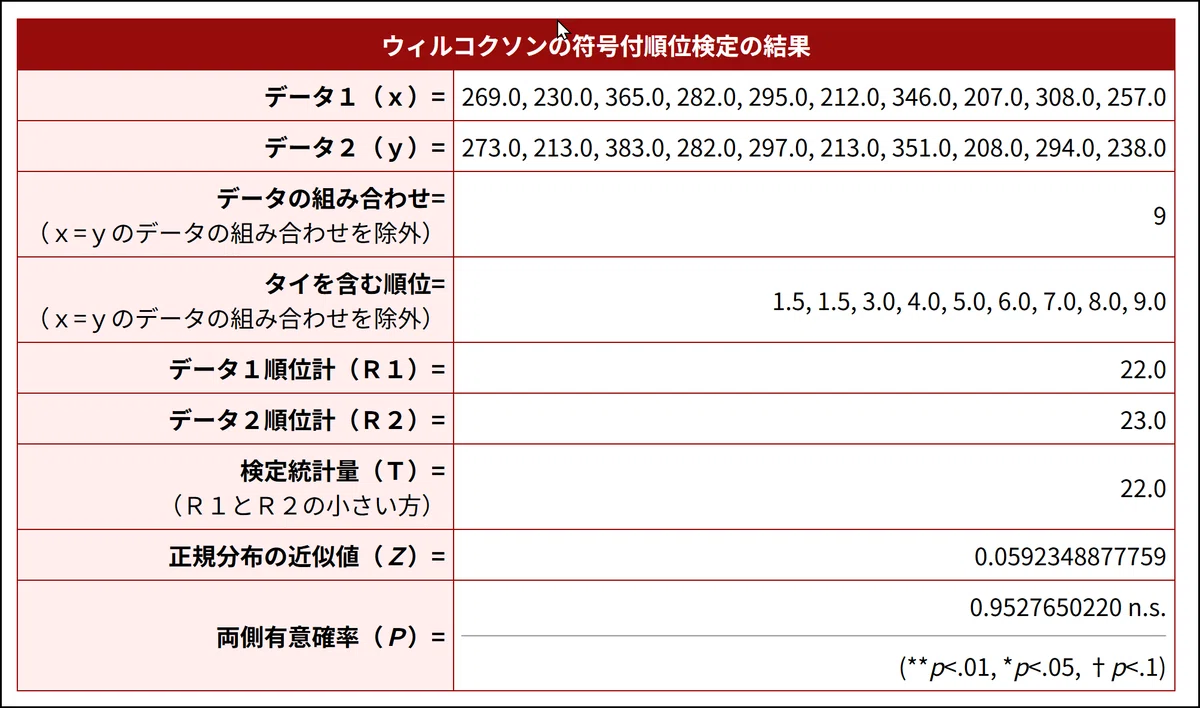
多くの統計ソフト(Rの標準パッケージなど)はWilcoxon法を採用していますが、ゼロ差が大量に存在するデータでこれを行うと、劇的なサンプルサイズ減少を招き、検出力が過剰に低下する懸念があります。ソフトウェアごとにどのアルゴリズムが採用されているかを把握し、事前に処理方針を規定しておくことが重要です。
誤解2:「中央値の差」を直接検定しているという思い込み
「ウィルコクソンの符号順位検定は中央値の差を検定する手法である」と簡略化して説明されるケースが多々あります。しかし厳密には、本検定が帰無仮説としているのは「ペア間の差の母集団分布がゼロに対して対称であること」です。
差の分布の形状が著しく非対称である場合、中央値のシフトと符号順位検定の検定結果が直感的に一致しないケースが生じ得ます。したがって、データの要約統計量を記述する際は、中央値(Median)および四分位範囲(IQR: 25%点〜75%点)を提示するとともに、差のヒストグラムや箱ひげ図を作成して分布の偏りを確認する姿勢が不可欠です。
【プロの結論】検定選択で失敗しないための判断基準
データ解析の現場で無用な手戻りや誤った意思決定を防ぐため、以下の明確なクライテリア(判断基準)に基づいて検定手法を決定してください。
ウィルコクソンの符号順位検定を選択すべき条件
- 同一被験者・ペアに対する「対応のある2群」の比較である。
- 差のデータに対してシャピロ・ウィルク検定を実施した結果、正規性が否定(p < 0.05)された。
- アンケートの満足度評価(5段階・7段階)など、順序尺度として収集されたデータである。
- サンプルサイズが小さく(例:$n < 30$)、正規分布に従っているかどうかの判断が困難である。
- データ内に極端な外れ値が含まれており、平均値を用いると結果が歪む恐れがある。
ウィルコクソンの符号順位検定を避けるべき(他の手法を検討すべき)条件
- データが明らかに正規分布に従っている場合:正規性が確認できる場合は「対応のあるt検定」を選択すべきです。ノンパラメトリック検定を無理に使うと、本来得られるはずの検出力(統計的パワー)を約5%程度損失します。
- 比較する2群が独立している場合:AグループとBグループの比較であれば、「マン・ホイットニーのU検定(または独立2群のt検定)」を採用します。
- 3時点以上の測定(事前・中間・事後など)を比較する場合:2群の検定を繰り返すと多重性の問題が生じるため、「フリードマン検定(Friedman test)」や「反復測定分散分析」を選択する必要があります。
【ウィルコクソン の 符号 順位 検定】に関するよくある質問(FAQ)
Q1:サンプルサイズが非常に小さい(例:n=5〜6)場合でも検定は有効ですか?
A1:計算自体は可能ですが、両側検定で有意水準5%(p < 0.05)を達成するためには、最低でも $n = 6$ 以上の観測ペアが必要です($n=5$ の場合、すべての符号が同一方向であってもp値は0.0625となり、0.05を下回ることができません)。極小サンプルの場合は「正確確率検定(Exact test)」が適用可能なソフトウェア(RやEZRなど)を利用してください。
Q2:結果を学会発表や論文で報告する際、どのような形式で数値を記載すべきですか?
A2:国際的なフォーマット(APAスタイルなど)では、代表値として「中央値(Median)と四分位範囲(IQR)」を提示した上で、検定統計量($T$ または $V$)、標準化検定統計量($Z$)、$p$ 値、そして効果量($r$)を明記します。
(記載例:A significant difference was found between pre and post scores ($Z = -2.41, p = 0.016, r = 0.54$, Median: pre 15.0 [IQR 13.5-17.5] vs post 18.5 [IQR 15.0-22.0]).)
Q3:同順位(タイ:Tie)が多数ある場合、検定結果にどのような影響がありますか?
A3:差の絶対値が同じ値になる「タイ」が存在する場合、通常の数式ではp値が過小または過大に評価される恐れがあります。タイの数に応じた分散の修正公式(タイ補正)を適用した正規近似、あるいはタイを適切に扱える正確順列検定(exact permutation test)を実行できるソフトウェア(Rの coin パッケージなど)を活用することが推奨されます。
まとめ:正しいノンパラメトリック検定の選定が分析の信頼性を決める
前後比較をはじめとする対応のある2群の分析において、データの前提条件(正規性や尺度水準)を無視した検定選択は、誤った結論を導く最大の要因となります。
データが正規分布に従わない場合や順序尺度である場合、ウィルコクソンの符号順位検定は最も頼りになる解析手法です。正規性の確認(シャピロ・ウィルク検定)、適切なソフトウェア(EZRやPython等)での実装、そしてp値だけでなく効果量($r$)を併記する厳謹な解釈プロセスを徹底することで、ビジネスの施策検証から学術研究に至るまで、確固たるエビデンスを構築してください。 (出典: ウィルコクソン の 符号 順位 検定(Yahoo!ニュース))
Webメディアの編集およびコンテンツ作成に従事。正確で質の高い情報発信を心掛けています。
